Qu’est-ce que le fichier llms.txt : ce que disent les données et si vous en avez vraiment besoin
Qu’est-ce que llms.txt, que révèlent 3 études sur les citations IA et quand faut-il l’installer ? Analyse concrète et données fiables, sans hype.

« Faut-il installer un fichier llms.txt sur notre site ? » Cette question attend souvent depuis des mois dans le backlog de nombreuses équipes SEO.
Je le constate dans presque tous les échanges autour de la visibilité sur les moteurs d’IA (GEO). Quelqu’un découvre un post sur LinkedIn, le partage avec l’équipe, et personne ne sait s’il faut y consacrer deux heures ou simplement passer à autre chose.
Voici mon avis objectif après avoir analysé les trois seules études indépendantes qui ont réellement mesuré son impact : la réponse n’est ni un simple oui ni un non catégorique. Je vous explique le rôle technique de ce fichier, ce que révèlent les données et dans quels cas précis il est pertinent de l’installer – ou de vous en passer.
Qu’est-ce que le fichier llms.txt et quel problème cherche-t-il à résoudre
Le fichier llms.txt est un format de fichier Markdown proposé pour être hébergé à la racine d’un site web, généralement sous l’adresse exemple.fr/llms.txt. Jeremy Howard, de chez Answer.AI, a introduit ce concept en 2024. Le principe est direct : au lieu de contraindre un robot d’IA à déduire seul l’architecture de votre site, vous lui transmettez une sélection ordonnée de vos pages les plus importantes.
Le problème technique sous-jacent est bien réel. Les pages web modernes contiennent un bruit considérable pour les modèles de langage. Une page classique mélange navigation, bannières de cookies, scripts tiers, blocs publicitaires et widgets de barre latérale avec le contenu informatif. Tout cela sature la fenêtre de contexte de l’IA – c’est-à-dire la mémoire de travail limitée dont dispose le modèle pour interpréter votre page.
Le fichier llms.txt supprime ce bruit superflu. Il indique au modèle : voici mon site, voici les dix pages qui comptent vraiment et voici un résumé clair pour chacune. Un contenu propre, rédigé en Markdown et immédiatement exploitable par une machine.
C’est précisément ce qui le sépare de robots.txt.
llms.txt vs robots.txt : deux rôles totalement différents
Ces deux fichiers sont fréquemment confondus, alors qu’ils répondent à des missions opposées.
robots.txt gère le contrôle d’accès. Il indique aux robots d’exploration quels répertoires du site ils sont autorisés ou non à parcourir. Ce standard existe depuis 1994 et l’ensemble des moteurs de recherche le respectent strictement.
llms.txt apporte du contexte et des suggestions. Il ne bloque ni n’autorise aucun accès technique. Il se contente de suggérer : « Lorsque vous visitez ce site, consultez en priorité ces pages précises. » C’est une recommandation informelle, sans obligation. Contrairement à robots.txt, rien ne garantit qu’un système d’IA ne prenne la peine de le lire.
| llms.txt | robots.txt | |
|---|---|---|
| Rôle | Contexte et orientation | Contrôle des accès |
| Cible | LLM, agents d’IA | Robots d’indexation des moteurs |
| Format | Markdown | Texte brut (Plain Text) |
| Statut | Proposition, sans standard officiel | Standard établi de l’industrie |
| Impact SEO | Aucun impact mesuré | Direct (budget de crawl, indexation) |
Pour visualiser la différence, imaginez robots.txt comme l’agent de sécurité à l’entrée d’un bâtiment qui vérifie les autorisations. Le fichier llms.txt est le concierge d’accueil qui vous remet un plan pour vous orienter vers les salles principales une fois que vous êtes déjà entré.
llms.txt vs llms-full.txt : quelle version devez-vous publier ?
La spécification prévoit deux variantes complémentaires.
llms.txt se comporte comme un sommaire. Il regroupe des liens vers vos pages maîtresses accompagnés de descriptions concises. Le système d’IA doit ensuite suivre chaque lien pour en extraire le texte intégral.
llms-full.txt constitue le recueil complet. Il rassemble directement dans un seul document l’intégralité du texte de vos pages stratégiques. Cela évite au modèle d’effectuer de multiples requêtes de crawl successives. C’est un format particulièrement apprécié pour les architectures RAG (Retrieval-Augmented Generation) et pour les assistants de développement comme Cursor ou Cline, qui peuvent ainsi charger toute une documentation d’un coup dans leur mémoire active.
Pour la majorité des sites web classiques, le fichier llms.txt suffit amplement. La variante llms-full.txt s’avère surtout utile si vous éditez une documentation technique ou si votre audience s’appuie sur des outils de programmation assistés par IA pour manipuler vos produits.
Ce que les données révèlent réellement sur le fichier llms.txt
Pour le dire sans détour : les données disponibles à ce jour n’indiquent aucun impact mesurable sur les citations dans les réponses d’IA.
La démonstration la plus étayée provient de l’analyse de SE Ranking : leurs chercheurs ont entraîné un modèle XGBoost sur près de 300 000 domaines pour identifier les facteurs corrélés aux citations d’IA. En supprimant la variable llms.txt du calcul, la précision du modèle prédictif s’est même améliorée. La présence de ce fichier n’apportait pas de signal utile, mais du simple bruit statistique.
D’autres études indépendantes sur l’adoption et le comportement des robots aboutissent exactement à la même conclusion.
Taux d’adoption : combien de sites l’ont réellement mis en place ?
Le chiffre varie selon le panel web analysé. Dans l’étude de SE Ranking portant sur près de 300 000 domaines (novembre 2025), seuls 10,13 % d’entre eux possédaient un fichier llms.txt. Neuf sites sur dix ne l’utilisaient donc pas.
D’autres observations confirment cet ordre de grandeur :
- Trakkr : 13,3 % sur un panel de 37 894 domaines fréquemment cités par les IA (mars 2026).
- Casey Burridge d’après les données du HTTP Archive : 5,61 % parmi les 10 000 sites mondiaux les plus visités (juin 2026).
- Semrush a recensé une progression de 951 domaines en juillet 2025 à 16 670 en septembre 2026.
La courbe d’adoption augmente indéniablement. Cependant, environ 16 000 domaines sur des centaines de millions de sites en ligne restent une proportion infime du web mondial.
Une nuance essentielle : une part non négligeable de cette adoption est involontaire. Des plateformes comme Wix, des hébergeurs de documentation comme Mintlify ou GitBook, ainsi que des extensions WordPress populaires comme Yoast SEO génèrent ce fichier par défaut. Trouver un llms.txt sur un domaine ne traduit donc pas systématiquement une décision réfléchie de l’équipe marketing.
Pourquoi Google et Chrome envoient des signaux opposés
En mai 2026, l’outil Chrome Lighthouse (version 13.3) a introduit un audit dédié à llms.txt au sein d’une nouvelle section intitulée « Agentic Browsing ». À partir de la version 13.5 (septembre 2026), ce contrôle a été intégré au groupe d’audits « Agent Resource Discovery ».
À peine dix jours après la sortie de Lighthouse 13.3, Google Search Central publiait une mise au point officielle : le moteur de recherche Google n’utilise pas llms.txt. La présence ou l’absence de ce fichier n’aide ni ne pénalise la visibilité dans les résultats de recherche ou dans les AI Overviews.
Chrome vérifie donc la présence du fichier, tandis que Google Search affirme ne pas s’en servir. Ces deux positions sont exactes car elles répondent à deux environnements distincts. Les ingénieurs de Chrome préparent le terrain pour les agents autonomes qui naviguent directement sur le web. Search Central s’exprime, lui, sur la façon dont Google extrait et classe les documents dans son index.
Il ne faut donc pas interpréter le contrôle de Lighthouse comme un signe que Googlebot s’appuie sur ce fichier pour attribuer des citations.
ChatGPT, Claude et Gemini lisent-ils vraiment votre fichier ?
En dehors des équipes internes de ces plateformes, personne ne peut l’affirmer formellement.
Ce que l’on sait avec certitude : OpenAI, Anthropic et Google publient tous un fichier llms.txt pour documenter leurs propres API et outils pour développeurs. Cela prouve qu’ils reconnaissent l’intérêt ergonomique du format. En revanche, publier son propre fichier est bien différent d’utiliser les fichiers tiers comme signal pour choisir ses sources.
À ce jour, aucun acteur majeur de l’IA générative n’a confirmé qu’un fichier llms.txt modifiait la probabilité d’être cité dans une réponse. Le seul usage documenté et avéré réside dans les outils d’aide au code – comme Cursor ou Cline – qui analysent le fichier llms.txt lorsque vous le leur transmettez explicitement via @Docs ou un connecteur MCP.
Comment créer un fichier llms.txt pas à pas
Si vous choisissez d’en déployer un, l’opération prend moins de 30 minutes. Le format s’appuie sur la spécification officielle v2, mise à jour en août 2026.
La structure utilise une syntaxe Markdown très simple :
# Nom de votre site ou de votre produit
> Une phrase claire résumant l'activité principale de votre site.

## Pages principales
- [Page produit](https://exemple.fr/produit/) : Ce que propose votre solution
- [Tarifs](https://exemple.fr/tarifs/) : Vue d'ensemble des offres et prix

## Articles de référence
- [Titre du guide](https://exemple.fr/blog/guide/) : L'enseignement clé en une ligne

## Optional
- [Ressource complémentaire](https://exemple.fr/ressource/) : Contexte secondaire
La section ## Optional indique aux agents autonomes les ressources qui peuvent être écartées lorsque leur fenêtre de mémoire doit être préservée.
Méthode 1 : Création manuelle (la référence)
Ouvrez un éditeur de texte brut. Créez un fichier intitulé llms.txt (entièrement en minuscules). Reprenez la structure présentée ci-dessus et déposez-le à la racine de votre serveur d’hébergement – exactement à l’emplacement de votre fichier robots.txt. Assurez-vous ensuite qu’il s’affiche correctement à l’adresse votredomaine.fr/llms.txt.
Limitez-vous à une sélection rigoureuse de 5 à 10 pages. Une sélection pertinente de vos pages produits, de vos articles de fond les plus solides et de votre page contact apportera bien plus de valeur à un agent d’IA qu’une liste automatisée de 200 URL sans hiérarchie.
Méthode 2 : WordPress avec Yoast ou AIOSEO
Si votre site tourne sous WordPress, des extensions comme Yoast SEO ou AIOSEO savent générer ce document automatiquement. Dans Yoast, rendez-vous dans Réglages → Fonctionnalités du site, descendez jusqu’à la section API et activez l’option llms.txt.
Le résultat est immédiat mais manque souvent de finesse stratégique, car l’outil y intègre des pages secondaires. Considérez cette génération automatique comme un point de départ et affinez la sélection manuellement.
Méthode 3 : Générateurs pour les autres CMS
Pour les autres architectures techniques, des plateformes comme Mintlify ou GitBook créent nativement le fichier pour les sites de documentation. L’outil Firecrawl permet également d’en construire une ébauche à partir d’un sitemap XML quel que soit votre CMS. Même recommandation : relisez toujours le fichier généré avant mise en production.
| Méthode | Niveau de contrôle | Temps requis | Maintenance |
|---|---|---|---|
| Manuelle | Total | 20 à 30 min | Manuelle à chaque refonte |
| Yoast / AIOSEO | Faible | 2 min | Automatique |
| Outils générateurs | Moyen | 10 min | Relecture manuelle requise |
À quoi ressemble un fichier llms.txt optimal en pratique
La qualité l’emporte nettement sur le volume. Un fichier comportant 8 pages soigneusement choisies et clairement résumées oriente bien mieux une IA qu’une suite de 150 URL brutes sans explications.
Ce qu’il faut inclure :
- Vos pages de produits ou services clés
- Vos guides et articles experts intemporels
- Votre grille tarifaire
- Votre page à propos ou de présentation
Ce qu’il faut écarter :
- Les pages privées ou protégées par mot de passe
- Les contenus éphémères (événements passés, promotions courtes)
- Les pages en doublon ou très proches
- Tout contenu que vous ne souhaitez pas voir utilisé comme source de vérité par une IA
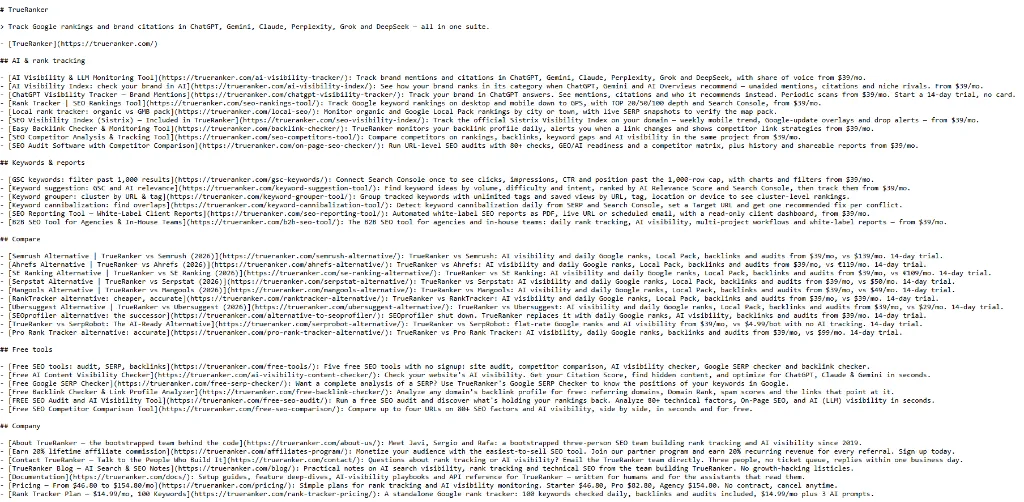
Vous pouvez examiner la structure complète d’un tel document directement sur notre propre fichier llms.txt.
Devez-vous vraiment ajouter un fichier llms.txt à votre site ?
Il n’existe pas de réponse unique valable pour tout le monde. La vraie question est : combien de temps vous demandera sa maintenance par rapport aux bénéfices attendus ?
Si votre CMS le génère déjà automatiquement
Laissez-le en ligne. Des CMS comme Wix ou des extensions WordPress le déploient sans surcoût. Tant qu’il ne vous coûte rien, le conserver ne présente aucun danger et pourrait se révéler utile avec le temps. Veillez seulement à sa cohérence : le risque principal serait de laisser traîner des URL obsolètes pointant vers des pages supprimées ou réorganisées.
Si vous devez le concevoir et le maintenir à la main
L’intérêt est alors beaucoup plus discutable. S’il vous faut cartographier votre site, rédiger les synthèses à la main et actualiser le fichier à chaque mise à jour éditoriale, vous engagez des ressources réelles pour un retour sur investissement totalement incertain.
D’autres actions SEO ont un impact infiniment supérieur : le balisage Schema.org, le maillage interne, la rigueur sémantique des contenus et les signaux E-E-A-T. Dans une démarche d’optimisation pour la recherche IA (GEO), ces piliers fondamentaux constituent le véritable point de départ.
Si vous ciblez spécifiquement des agents de code ou des outils de développement
C’est précisément dans cette configuration que le fichier prend tout son sens. Si vos utilisateurs travaillent avec des documentations techniques ou des flux d’ingénierie logicielle, leur fournir une synthèse propre en Markdown facilite immédiatement le travail des assistants. L’exploitation de llms.txt par des agents comme Cursor ou Cline via des serveurs MCP est aujourd’hui son seul bénéfice tangible.
Abordez donc ce fichier comme une expérimentation ciblée, non comme une exigence universelle. Ce qui nous amène à la question que la majorité des publications oublient de traiter.
Comment mesurer si le fichier llms.txt a un impact réel sur votre site
Tout le monde détaille la syntaxe de llms.txt et sa création. Presque personne n’explique comment vérifier s’il améliore réellement votre visibilité. C’est le manque que nous voulons combler ici.
Ne vous contentez pas de tester quelques requêtes au hasard sur ChatGPT une semaine après la mise en ligne. Les réponses des modèles de langage fluctuent naturellement, et une citation isolée ne constitue en rien une preuve de causalité.
Établissez une référence chiffrée (baseline) avant la publication.
Analysez d’abord votre niveau de présence actuel dans les assistants d’IA : sur quelles requêtes votre marque ressort-elle, quels moteurs vous citent et à quel rythme ? Si vous suivez déjà votre visibilité IA avec un outil dédié, exportez vos indicateurs avant de mettre le fichier en ligne.
Il est primordial de garder à l’esprit que la visibilité dans les moteurs IA fonctionne très différemment du classement Google – les critères d’apparition ne répondent pas aux mêmes règles.
Observez vos données sur une période de 4 à 6 semaines à conditions constantes.
Évitez de lancer simultanément une refonte de contenu massive, une campagne de netlinking ou une réécriture complète de vos pages phares pendant le test. Vous devez isoler la variable du fichier llms.txt le plus rigoureusement possible.
Suivez un groupe de contrôle de requêtes.
Sélectionnez des requêtes pour lesquelles les URL répertoriées dans votre llms.txt n’ont aucun lien direct. Si votre taux de citation évolue de façon similaire sur les requêtes ciblées et sur votre groupe de contrôle, le fichier llms.txt n’y est probablement pour rien.
Voir un robot récupérer /llms.txt dans vos journaux de serveur atteste simplement qu’une requête HTTP a eu lieu. Cela ne prouve en aucun cas que le système a exploité ce fichier pour vous citer. Le seul indicateur valable est l’évolution constatée de votre visibilité réelle dans les réponses générées.
C’est cette méthode comparative qui vous apportera des certitudes au lieu de simples suppositions.
Foire aux questions (FAQ)
Le fichier llms.txt influence-t-il vos classements SEO traditionnels ?
Non. Ce document s’adresse aux robots et agents d’IA, pas aux algorithmes de classement traditionnels des moteurs de recherche. Les journaux de serveurs montrent d’ailleurs que Googlebot n’appelle pas llms.txt – une étude de 31 jours menée par Nathan Hall sur sept sites a relevé zéro requête. L’installation ou l’absence de ce fichier n’a aucun effet sur vos positions classiques.
Combien de liens devez-vous inclure dans votre llms.txt ?
Visez un ensemble de 5 à 10 liens soigneusement hiérarchisés. Ils doivent représenter vos offres phares, vos publications d’autorité et vos pages institutionnelles clés. Une sélection concise apporte bien plus de clarté à une IA qu’une arborescence géante dénuée de contexte.
Faut-il placer le fichier llms.txt en noindex pour Google ?
Oui, c’est une excellente pratique. Ce fichier constitue un document d’orientation technique, pas un contenu destiné à ressortir dans les résultats de recherche Google. L’en-tête noindex évite qu’il n’encombre l’index, tout en laissant les robots d’IA le lire librement – l’exploration et l’indexation étant deux étapes bien séparées.
Peut-on utiliser llms.txt pour bloquer l’entraînement des modèles d’IA ?
Non. Le fichier llms.txt sert à guider les agents d’IA pendant la génération d’une réponse en direct (inférence), pas à restreindre l’apprentissage sur vos données. Pour refuser que vos contenus soient exploités pour entraîner des modèles, utilisez votre fichier robots.txt avec des directives du type User-agent: GPTBot suivi de Disallow: /. C’est le mécanisme prévu pour cela.
Le fichier llms.txt permet-il d’obtenir plus de citations dans ChatGPT ou Gemini ?
Aucune donnée ne le démontre aujourd’hui. L’analyse de SE Ranking sur 300 000 sites n’a décelé aucune corrélation entre la présence du fichier et la fréquence des citations. De son côté, John Mueller de chez Google a rappelé dans le podcast Search Off the Record que les moteurs ne peuvent pas se fier à un document auto-déclaré pour évaluer la pertinence d’un site. Si vous l’adoptez, mesurez-en l’impact plutôt que de le présumer.
Que se passe-t-il si vous ne mettez pas à jour votre fichier llms.txt ?
Le principal danger réside dans les liens morts ou obsolètes. Si votre fichier renvoie les agents d’IA vers des pages retirées ou restructurées, vous risquez de les guider vers des contenus inexacts. Si vous décidez de déployer un fichier llms.txt, prévoyez un rappel régulier pour vérifier son exactitude à chaque évolution notable de votre site.
Savez-vous à quel point votre marque est visible dans les réponses IA ?
Mesurez votre visibilité IA sur ChatGPT, Gemini et Perplexity et identifiez ce qui fait réellement bouger les lignes.
Écrit par
Javier Quevedo
Cofondateur & CEO, SEO Lead
Javier a cofondé TrueRanker et dirige le frontend, le site public et le dernier kilomètre entre un ranking en base et l’écran qu’un SEO utilise vraiment. Depuis des années, il transforme GEO, SEO local, on-page et visibilité IA en produit — et en guides sur ce blog — pour que les agences mesurent les citations ChatGPT comme elles mesurent déjà Google. Il travaille aussi le backend : une interface propre sur des données périmées reste un mensonge.
Cela pourrait vous intéresser
La checklist d’optimisation pour la recherche IA que je passe avant de modifier une page.
Avec la checklist d’optimisation pour la recherche IA, vous prenez un prompt, voyez citation ou mention, et si modifier la page a servi à quelque chose.
Javier Quevedo11 min de lecture
Lire l’articleLes facteurs de visibilité IA ne comptent que si vous êtes cité.
Si un concurrent est cité par ChatGPT à votre place, c’est là qu’entrent en jeu les facteurs de visibilité IA. Voici ce que je vérifie sur un prompt.
Javier Quevedo14 min de lecture
Lire l’articlePourquoi votre classement Google ne dit rien de votre visibilité IA
Être 3e sur Google ne vous met pas dans la réponse de ChatGPT. Pourquoi les deux ont divergé et quoi mesurer à la place.
TrueRanker3 min de lecture
Lire l’article