Was ist llms.txt: Was die Daten sagen und ob du die Datei wirklich brauchst
Was bringt llms.txt wirklich? Drei Studien zu KI-Zitaten, der Unterschied zu robots.txt und wann sich die Datei für Websites lohnt. Daten statt Hype.

„Sollten wir dringend eine llms.txt einrichten?“ Diese Frage liegt derzeit im Backlog vieler SEO-Teams.
Ich erlebe das in fast jedem Gespräch über GEO. Jemand liest einen Beitrag auf LinkedIn, teilt ihn im Team, und am Ende weiß niemand, ob man dafür zwei Stunden Arbeit reservieren oder das Thema einfach ignorieren sollte.
Hier ist meine ehrliche Einschätzung, nachdem ich die drei unabhängigen Studien analysiert habe, die den Effekt tatsächlich gemessen haben: Die Antwort ist weder ein pauschales Ja noch ein klares Nein. Ich zeige dir, wie die Datei technisch funktioniert, was die Datenlage belegt und wann sich die Einrichtung für dich lohnt – oder wann du deine Zeit sparst.
Was llms.txt ist und welches Problem die Datei lösen soll
llms.txt ist ein Formatvorschlag für eine Markdown-Datei, die direkt im Stammverzeichnis einer Website liegt – typischerweise unter beispiel.de/llms.txt. Jeremy Howard von Answer.AI hat das Konzept 2024 vorgestellt. Die Grundidee ist simpel: Statt einen KI-Crawler mühsam die gesamte Struktur einer Website erraten zu lassen, gibst du ihm eine kuratierte Liste deiner wichtigsten Inhalte an die Hand.
Das Problem dahinter ist real. Klassische Webseiten erzeugen enorm viel Rauschen für große Sprachmodelle. Eine durchschnittliche Seite packt Navigation, Cookie-Banner, Skripte, Werbebanner und Sidebar-Widgets um den eigentlichen Inhalt. All das verbraucht wertvolle Tokens im Kontextfenster der KI – also dem begrenzten Arbeitsspeicher, den ein Modell beim Verarbeiten einer Seite zur Verfügung hat.
Eine llms.txt filtert diesen Ballast heraus. Sie signalisiert dem Modell: Das ist mein Angebot, das sind die zehn wichtigsten Seiten und hier ist jeweils eine prägnante Zusammenfassung. Sauber strukturiert, in Markdown und maschinenlesbar.
Genau das unterscheidet sie grundlegend von der robots.txt.
llms.txt vs. robots.txt: Zwei völlig unterschiedliche Aufgaben
Viele verwechseln die beiden Dateien oder werfen sie in einen Topf. Sie erfüllen jedoch zwei völlig verschiedene Aufgaben.
robots.txt dient der Zugriffskontrolle. Sie teilt Crawlern verbindlich mit, welche Bereiche einer Website sie besuchen dürfen und welche nicht. Der Standard existiert seit 1994 und wird von allen etablierten Suchmaschinen-Crawlern respektiert.
llms.txt dient der Orientierung und dem Kontext. Sie erteilt weder Zugriffsrechte noch sperrt sie Verzeichnisse. Sie sagt lediglich: „Wenn du meine Seite besuchst, schau dir bitte diese Inhalte zuerst an.“ Es ist eine unverbindliche Empfehlung. Im Gegensatz zu robots.txt gibt es keinerlei Garantie, dass ein KI-System die Datei überhaupt beachtet.
| llms.txt | robots.txt | |
|---|---|---|
| Zweck | Orientierung und Kontext | Zugriffskontrolle |
| Zielgruppe | LLMs, KI-Agenten | Suchmaschinen-Crawler |
| Format | Markdown | Plain Text |
| Standard | Vorschlag, kein Webstandard | Etablierter Industriestandard |
| SEO-Effekt | Bislang nicht nachgewiesen | Direkt (Crawl-Budget, Indexierung) |
Stell dir robots.txt wie den Sicherheitsdienst am Eingang vor, der den Zutritt regelt. Die llms.txt ist dagegen der Concierge im Foyer, der Besuchern den Weg zu den wichtigsten Räumen weist, sobald sie bereits im Gebäude sind.
llms.txt vs. llms-full.txt: Welche Variante solltest du nutzen?
Die Spezifikation definiert zwei Varianten der Datei.
llms.txt funktioniert wie ein Inhaltsverzeichnis. Sie enthält Links zu deinen wichtigsten Seiten samt kurzen Beschreibungen. Die KI muss diesen Links folgen, um den vollständigen Inhalt abzurufen.
llms-full.txt ist das vollständige Kompendium. Sie bündelt den gesamten Text deiner wichtigsten Seiten direkt in einer einzigen Datei. Das spart nachgelagerte Crawling-Schritte. Nützlich ist das vor allem für RAG-Systeme (Retrieval-Augmented Generation) und für Coding-Agenten wie Cursor oder Cline, die Dokumentation direkt in ihren Arbeitskontext laden.
Für die meisten Websites genügt die Standarddatei llms.txt vollkommen. Die Variante llms-full.txt lohnt sich vor allem dann, wenn du Entwicklerdokumentationen betreibst oder deine Zielgruppe intensiv KI-Coding-Tools nutzt, um mit deinem Produkt zu interagieren.
Was die Datenlage tatsächlich über llms.txt aussagt
Um es direkt auf den Punkt zu bringen: Bislang gibt es keine empirischen Belege dafür, dass eine llms.txt die Zitate in KI-Antworten steigert.
Die deutlichsten Daten liefert eine Analyse von SE Ranking: Die Forscher trainierten ein XGBoost-Modell anhand von fast 300.000 Domains, um herauszufinden, welche Faktoren KI-Zitate vorhersagen. Als sie die Variable llms.txt aus dem Modell entfernten, stieg die Genauigkeit der Vorhersage sogar an. Das Vorhandensein der Datei lieferte kein klares Signal, sondern statistisches Rauschen.
Auch andere unabhängige Auswertungen zu Verbreitung und Crawling-Verhalten kommen zu einem sehr ähnlichen Ergebnis.
Verbreitung im Web: Wie viele Websites nutzen die Datei?
Der tatsächliche Anteil hängt stark davon ab, welchen Ausschnitt des Webs man betrachtet. In der Studie von SE Ranking unter fast 300.000 Domains (Stand November 2025) verfügten lediglich 10,13 % über eine llms.txt. Neun von zehn Websites verzichteten komplett darauf.
Weitere Analysen zeigen ein vergleichbares Bild:
- Trakkr: 13,3 % unter 37.894 Domains, die in KI-Antworten zitiert wurden (März 2026).
- Casey Burridge auf Basis von HTTP Archive-Daten: 5,61 % unter den Top-10.000 Websites weltweit (Juni 2026).
- Semrush beobachtete ein Wachstum von 951 Domains im Juli 2025 auf 16.670 Domains im September 2026.
Die Kurve zeigt zwar nach oben. Allerdings sind rund 16.000 Domains gemessen an Hunderten Millionen aktiver Websites weltweit nach wie vor ein winziger Bruchteil.
Ein wichtiger Aspekt dabei: Ein Teil dieser Verbreitung entsteht völlig unbeabsichtigt. Content-Management-Systeme wie Wix, Dokumentationsplattformen wie Mintlify oder GitBook sowie WordPress-Plugins wie Yoast SEO erstellen die Datei mittlerweile automatisch. Wenn eine Domain eine llms.txt aufweist, bedeutet das keineswegs, dass das Team dahinter eine bewusste SEO-Entscheidung getroffen hat.
Widersprüchliche Signale von Google und Chrome
Im Mai 2026 führte das Google-Tool Chrome Lighthouse (Version 13.3) eine Prüfung auf llms.txt unter der neuen Kategorie „Agentic Browsing“ ein. Mit Version 13.5 (September 2026) wanderte dieser Check in die Prüfgruppe „Agent Resource Discovery“.
Nur zehn Tage nach dem Release von Lighthouse 13.3 veröffentlichte Google Search Central eine offizielle Klarstellung: Die Google-Suche nutzt llms.txt nicht. Das Einrichten der Datei verbessert oder verschlechtert weder die Sichtbarkeit in der klassischen Websuche noch in KI-Features wie den AI Overviews.
Chrome prüft also das Vorhandensein der Datei, während Google Search klarstellt, sie nicht zu verwenden. Beide Aussagen stimmen, weil sie sich auf zwei unterschiedliche Systeme beziehen. Das Chrome-Team denkt an browserbasierte KI-Agenten, die eigenständig durch das Web navigieren. Search Central beschreibt hingegen, wie Google Inhalte für den Suchindex erfasst und bewertet.
Der Lighthouse-Audit sollte daher nicht als Beleg dafür missverstanden werden, dass Googlebot deine llms.txt für Rankings oder Zitate auswertet.
Lesen ChatGPT, Claude und Gemini deine llms.txt überhaupt aus?
Von offizieller Seite lässt sich das außerhalb der jeweiligen Entwicklerteams nicht bestätigen.
Bekannt ist: OpenAI, Anthropic und Google stellen jeweils eigene llms.txt-Dateien für ihre Entwicklerdokumentationen bereit. Die Unternehmen sehen also durchaus einen praktischen Wert im Format. Eine eigene Datei anzubieten, ist jedoch etwas völlig anderes, als fremde Dateien als Zitationssignal für Antworten heranzuziehen.
Bislang hat keine der großen KI-Plattformen öffentlich bestätigt, dass eine llms.txt Einfluss darauf nimmt, welche Websites in KI-Antworten erwähnt oder verlinkt werden. Der klarste dokumentierte Einsatzzweck sind Coding-Assistenten – etwa Cursor oder Cline, die eine llms.txt gezielt einlesen, wenn Entwickler sie per @Docs oder über einen MCP-Server als Kontext übergeben.
So erstellst du eine llms.txt Datei Schritt für Schritt
Wenn du dich für eine Umsetzung entscheidest, ist der Aufwand gering und in unter 30 Minuten erledigt. Das Format richtet sich nach der offiziellen v2-Spezifikation, die im August 2026 aktualisiert wurde.
Der Aufbau basiert auf einfachem Markdown:
# Name deiner Website oder deines Produkts
> Eine prägnante Zusammenfassung in einem Satz, worum es auf deiner Website geht.

## Kernseiten
- [Produktseite](https://beispiel.de/produkt/): Was dein Hauptprodukt auszeichnet
- [Preise](https://beispiel.de/preise/): Tarife und Preisübersicht

## Wichtige Fachartikel
- [Titel des Leitfadens](https://beispiel.de/blog/ratgeber/): Kernaussage in einer Zeile

## Optional
- [Weiterführende Ressource](https://beispiel.de/ressource/): Hintergrundinfos mit niedrigerer Priorität
Der Bereich ## Optional signalisiert KI-Agenten, welche Inhalte bei knappem Kontextfenster ohne Informationsverlust übersprungen werden können.
Methode 1: Manuelle Erstellung (die sauberste Lösung)
Öffne einen einfachen Texteditor. Erstelle eine Datei namens llms.txt (durchgehend in Kleinbuchstaben). Baue die Struktur nach dem obigen Schema auf und lade die Datei in das Root-Verzeichnis deines Webservers hoch – genau dorthin, wo auch die robots.txt liegt. Prüfe anschließend im Browser, ob sie unter deinedomain.de/llms.txt fehlerfrei erreichbar ist.
Wähle maximal 5 bis 10 Seiten aus. Eine handverlesene Liste deiner wichtigsten Produktseiten, der stärksten Fachartikel und der Kontakt- oder Über-uns-Seite hilft KI-Agenten deutlich mehr als ein automatisierter Export von 200 beliebigen URLs.
Methode 2: WordPress mit Yoast oder AIOSEO
Auf WordPress-Websites können Plugins wie Yoast SEO oder AIOSEO die Datei automatisch generieren. In Yoast findest du die Option unter Einstellungen → Website-Funktionen: Scrolle zum Bereich APIs und aktiviere den Schalter für llms.txt.
Das Ergebnis entsteht vollautomatisch, spiegelt aber oft keine klare Strategie wider, da häufig auch unwichtige Unterseiten aufgenommen werden. Sieh das generierte Dokument als ersten Entwurf und passe die Links anschließend manuell an.
Methode 3: Generatoren für andere Systeme
Für andere Content-Management-Systeme und Tech-Stacks gibt es spezialisierte Lösungen. Plattformen wie Mintlify oder GitBook binden die Datei bei Dokumentationsseiten automatisch ein. Mit Tools wie Firecrawl lässt sich aus einer bestehenden Sitemap ein Entwurf für beliebige Stacks generieren. Auch hier gilt: Überprüfe die Ausgabe vor der Veröffentlichung kritisch.
| Methode | Kontrolle | Zeitaufwand | Wartung |
|---|---|---|---|
| Manuell | Vollständig | 20–30 Min. | Manuell bei jeder Änderung |
| Yoast / AIOSEO | Gering | 2 Min. | Automatisch |
| Generator-Tools | Mittel | 10 Min. | Manuelle Überprüfung erforderlich |
Wie eine optimale llms.txt in der Praxis aussieht
Qualität steht klar vor Quantität. Eine Datei mit 8 durchdacht ausgewählten und präzise beschriebenen Seiten liefert einem KI-Agenten weit mehr Orientierung als eine wahllose Ansammlung von 150 Links ohne Kontext.
Was hineingehört:
- Zentrale Produkt- oder Dienstleistungsseiten
- Deine stärksten, zeitlosen Fachartikel
- Preisübersicht
- Über-uns-Seite
Was du weglassen solltest:
- Geschützte Seiten oder Login-Bereiche
- Zeitlich befristete Inhalte (Veranstaltungsseiten, kurzzeitige Aktionen)
- Duplizierte oder sehr ähnliche URLs
- Alle Seiten, die ein KI-Modell nicht als maßgebliche Hauptquelle betrachten soll
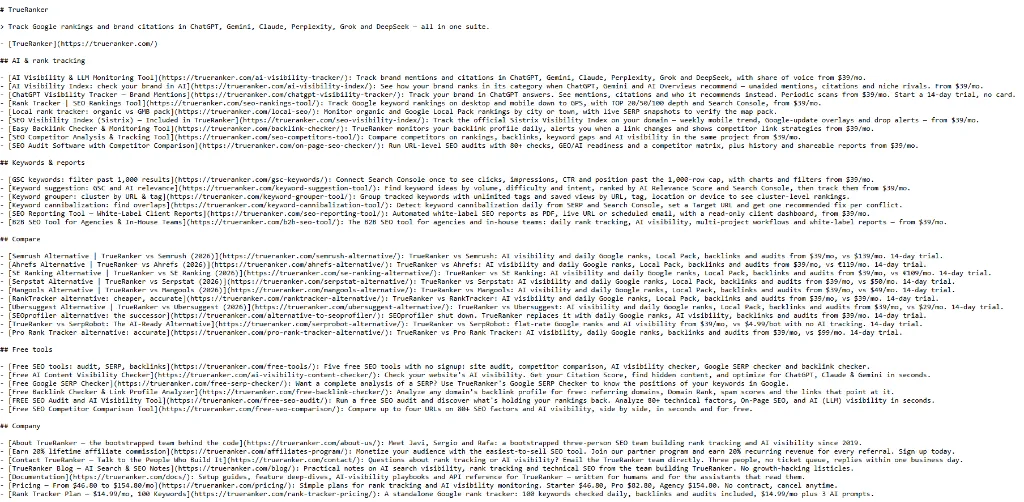
Du kannst die vollständige Datei und ihren genauen Aufbau in unserer eigenen llms.txt ansehen.
Solltest du llms.txt auf deiner Website einrichten?
Es gibt keine für alle Websites passende Pauschalantwort. Die entscheidende Frage lautet: Welcher personelle und zeitliche Aufwand entsteht dir durch die laufende Pflege?
Wenn dein CMS die Datei bereits automatisch anlegt
Lass die Datei aktiv. Plattformen wie Wix, Mintlify, GitBook oder WordPress-Plugins generieren sie ohne Zusatzkosten. Wenn sie bereits existiert, ist das Risiko minimal und bei steigender Bedeutung potenziell nützlich. Achte lediglich auf Aktualität: Das größte Risiko besteht darin, dass veraltete URLs KI-Agenten auf Inhalte lenken, die du längst umstrukturiert oder entfernt hast.
Wenn du die Datei komplett manuell pflegen müsstest
Hier ist die Rechtfertigung schwieriger. Wenn die Erstellung bedeutet, dass du deine Website auditieren, Links händisch kuratieren, Beschreibungen verfassen und die Datei bei jedem Relaunch oder neuen Artikel aktualisieren musst, investierst du reale Arbeitszeit für einen ungesicherten Ertrag.
Es gibt SEO-Maßnahmen mit deutlich größerer Hebelwirkung: saubere strukturierte Daten, eine durchdachte interne Verlinkung, inhaltliche Klarheit und nachvollziehbare E-E-A-T-Signale. In einem umfassenden Leitfaden zur Optimierung für KI-Suchsysteme (GEO) sind diese Grundlagen der eigentliche Ausgangspunkt.
Wenn du gezielt Coding-Agenten oder Entwickler-Tools ansprechen willst
In diesem Szenario ergibt eine gezielte Umsetzung am meisten Sinn. Wenn deine Zielgruppe mit technischen Dokumentationen oder Entwickler-Workflows arbeitet, erleichtert ein sauberes Inhaltsverzeichnis den Systemen die Arbeit spürbar. Coding-Agenten, die deine llms.txt über Tools wie Cursor oder Cline einlesen, stellen heute den greifbarsten Praxiseffekt dar.
Betrachte die Datei als kontrolliertes Experiment, nicht als zwingende Pflicht. Was uns zum Aspekt führt, den die meisten Anleitungen komplett verschweigen.
So misst du, ob llms.txt auf deiner Website wirklich etwas bewirkt
Nahezu jeder Blogbeitrag erklärt, was llms.txt ist und wie man sie anlegt. Kaum jemand zeigt jedoch, wie man überprüft, ob sich dadurch überhaupt etwas an der Sichtbarkeit ändert. Genau diese Lücke schließen wir hier.
Verzichte darauf, eine Woche nach dem Upload willkürlich ein paar Prompts in ChatGPT einzugeben. Das liefert keine verwertbaren Erkenntnisse, da KI-Antworten naturgemäß schwanken und eine einzelne gute Woche reiner Zufall sein kann.
Definiere eine saubere Baseline vor der Veröffentlichung.
Erfasse zunächst deinen aktuellen Status quo in generativen Suchsystemen: Bei welchen Prompts taucht deine Marke auf, welche KI-Systeme zitieren dich und mit welcher Häufigkeit? Wenn du deine KI-Sichtbarkeit bereits in einem Tool für Ranking-Monitoring misst, exportiere diese Messreihe, bevor du die Datei online stellst.
Dabei hilft das Verständnis dafür, wie sich die Sichtbarkeit in KI-Antworten von traditionellen Google-Rankings unterscheidet – die Kennzahlen entwickeln sich nach ganz anderen Mustern.
Beobachte die Daten über 4 bis 6 Wochen bei stabilen Rahmenbedingungen.
Vermeide während der Testphase größere Content-Offensiven, den massiven Aufbau von Backlinks oder grundlegende Überarbeitungen deiner meistzitierten Seiten. Isoliere die Variable llms.txt so gut wie möglich.
Arbeite mit einer Kontrollgruppe von Prompts.
Wähle Prompts aus, für die die in deiner llms.txt genannten URLs thematisch nicht relevant sind. Wenn deine Sichtbarkeit über beide Gruppen hinweg gleichmäßig ansteigt oder fällt, ist die Datei mit hoher Wahrscheinlichkeit nicht die Ursache dafür.
Wenn ein Crawler in deinen Server-Logs die /llms.txt abruft, beweist das lediglich die Anfrage an die Datei. Es beweist nicht, dass das KI-System sie verwendet hat, um deine Inhalte auszuwählen oder ein Zitat zu erzeugen. Das einzig relevante Ergebnis ist, ob sich deine tatsächliche KI-Sichtbarkeit verändert.
Erst durch diesen Vorher-Nachher-Vergleich erhältst du belastbare Fakten statt Vermutungen.
Häufig gestellte Fragen (FAQ)
Beeinflusst llms.txt meine klassischen Google-Rankings?
Nein. Die Datei richtet sich an KI-Crawler und Agenten, nicht an die traditionellen Indexierungs-Crawler für Suchmaschinen. Logdaten zeigen, dass Googlebot llms.txt überhaupt nicht anfordert – in einer 31-tägigen Messung von Nathan Hall über sieben Domains gab es null Anfragen. Weder das Vorhandensein noch das Fehlen der Datei hat negative Auswirkungen auf dein klassisches Ranking.
Wie viele Links gehören in eine llms.txt?
Empfehlenswert sind 5 bis 10 strategisch ausgewählte Links. Diese sollten deine Kernprodukte, deine fundiertesten Fachartikel und wichtige Profilseiten abbilden. Eine kurze, gepflegte Auswahl bietet KI-Systemen einen deutlich höheren Mehrwert als eine vollständige Sitemap mit Hunderten URLs.
Sollte ich llms.txt für Google auf noindex setzen?
Ja, das ist Best Practice. Die Datei dient als Orientierung für KI-Systeme und stellt keinen Inhalt dar, der in den Suchergebnissen von Google ranken soll. Mit einer noindex-Anweisung verhinderst du, dass sie im Google-Index landet, während KI-Crawler sie weiterhin problemlos erfassen können – Crawling und Indexierung sind zwei getrennte Prozesse.
Kann ich mit llms.txt das KI-Training blockieren?
Nein. Die llms.txt dient der Steuerung von KI-Agenten während der Beantwortung von Nutzerfragen (Inference), nicht der Kontrolle von Trainingsdaten. Wenn du das KI-Training für deine Inhalte unterbinden möchtest, nutzt du die robots.txt mit Anweisungen wie User-agent: GPTBot und Disallow: /. Das ist das passende Werkzeug für diese Aufgabe.
Sorgt llms.txt für mehr Zitate in ChatGPT oder Gemini?
Nach aktuellem Erkenntnisstand lässt sich das nicht nachweisen. Die Untersuchung von SE Ranking an 300.000 Domains fand keinen messbaren Zusammenhang zwischen der Datei und der Zitationshäufigkeit. Auch Google-Analyst John Mueller betonte im Search Off the Record Podcast, dass Suchmaschinen sich nicht auf eine selbst deklarierte Datei verlassen können, um die Qualität von Websites zu bewerten. Wer die Datei einsetzt, sollte den Effekt messen, statt blind darauf zu vertrauen.
Was passiert, wenn ich die Datei nicht regelmäßig aktualisiere?
Veraltete Links sind das größte Risiko. Wenn deine Datei auf Seiten verweist, die du gelöscht, umbenannt oder inhaltlich verändert hast, führst du KI-Agenten zu Inhalten, die dein Unternehmen unzureichend repräsentieren. Wenn du eine llms.txt veröffentlichst, plane eine regelmäßige Überprüfung ein, sobald du deine Website-Struktur oder Kernseiten anpasst.
Weißt du, wie sichtbar deine Marke in KI-Antworten ist?
Miss deine KI-Sichtbarkeit in ChatGPT, Gemini und Perplexity und erkenne sofort, welche Optimierung wirklich etwas bewegt.
Geschrieben von
Javier Quevedo
Mitgründer & CEO, SEO Lead
Javier hat TrueRanker mitgegründet und führt Frontend, öffentliche Website und die letzte Meile zwischen einem Ranking in der Datenbank und dem Screen, den ein SEO wirklich nutzt. Seit Jahren macht er aus GEO, Local SEO, On-Page und KI-Sichtbarkeit Produkt — und die Guides in diesem Blog — damit Agenturen ChatGPT-Zitationen so messen wie Google. Er arbeitet auch am Backend: eine saubere Oberfläche über alten Daten ist reine Augenwischerei.
Das könnte Sie interessieren
Die Checkliste zur KI-Suchoptimierung, die ich durchgehe, bevor ich eine Seite ändere.
Mit der Checkliste zur KI-Suchoptimierung nimmst du einen Prompt, prüfst Zitat oder Erwähnung und schaust, ob die Seitenänderung etwas gebracht hat.
Javier Quevedo10 Min. Lesezeit
Beitrag lesenRanking-Faktoren in der KI-Suche zählen erst, wenn sich das Zitat ändert.
Warum eine Seite in ChatGPT oder Perplexity zitiert wird und eine andere nicht: Ranking-Faktoren in der KI-Suche – und was ich an einem Prompt prüfe.
Javier Quevedo11 Min. Lesezeit
Beitrag lesen