Qué es llms.txt: lo que dicen los datos y si de verdad lo necesitas
Qué es llms.txt, qué dicen tres estudios sobre su impacto en citas de IA y cuándo tiene sentido añadirlo. Sin hype, solo datos.

«¿Deberíamos crear el archivo llms.txt?» Esa pregunta lleva un año sin resolverse en el backlog de muchos equipos SEO.
Lo veo en todas las conversaciones sobre GEO. Alguien lee un hilo en LinkedIn, lo comenta en el equipo, y nadie sabe si merece dos horas de trabajo o directamente pasarlo a la siguiente semana.
Mi respuesta honesta, después de leer los tres estudios que realmente lo han medido: la pregunta no tiene una respuesta universal, pero sí tiene una respuesta para tu caso concreto. Te explico qué hace el archivo, qué dicen los datos y cuándo tiene sentido añadirlo (y cuándo no).
Qué es llms.txt y qué problema resuelve
llms.txt es un archivo Markdown que se aloja en la raíz de tu dominio, normalmente en ejemplo.com/llms.txt. Jeremy Howard de Answer.AI propuso el formato en 2024. La idea es directa: en lugar de que un rastreador de IA tenga que inferir la estructura de tu sitio por su cuenta, tú le das una lista curada de tus páginas más relevantes.
El problema que intenta resolver es real. Las páginas web son ruidosas para los modelos de lenguaje. Una página típica mezcla navegación, banners de cookies, scripts, anuncios y widgets con el contenido real. Todo eso consume ventana de contexto (la «memoria de trabajo» que el modelo tiene mientras procesa tu página).
llms.txt elimina ese ruido. Le dice: este es mi sitio, estas son las diez páginas que importan, aquí tienes una línea sobre cada una. Limpio, en Markdown, legible por máquinas.
Eso es lo que lo separa del robots.txt.
llms.txt vs robots.txt: dos trabajos distintos
Mucha gente los confunde. No son intercambiables.
robots.txt es control de acceso. Le dice a los rastreadores qué partes del sitio pueden visitar. Existe desde 1994 y todos los crawlers de motores de búsqueda lo respetan.
llms.txt es contexto y orientación. No concede ni bloquea el acceso. Simplemente sugiere: «cuando entres, presta atención a estas páginas primero». Es una recomendación, no una orden. A diferencia de robots.txt, no hay ninguna garantía de que los sistemas de IA lo lean.
| llms.txt | robots.txt | |
|---|---|---|
| Propósito | Orientación y contexto | Control de acceso |
| Audiencia | LLMs, agentes de IA | Rastreadores de motores de búsqueda |
| Formato | Markdown | Texto plano |
| Cumplimiento | Opcional, sin estándar | Estándar del sector |
| Impacto en SEO | Sin confirmar | Directo (presupuesto de rastreo, indexación) |
Piensa en el robots.txt como el guardia de seguridad en la puerta y en el llms.txt como el recepcionista que explica el edificio a un visitante que ya está dentro.
llms.txt vs llms-full.txt: cuál publicar
La especificación define dos variantes:
llms.txt es un índice. Contiene enlaces a tus páginas más importantes con descripciones breves. El agente de IA tiene que seguir esos enlaces para llegar al contenido.
llms-full.txt es el compendio completo. Agrupa el texto íntegro de tus páginas más relevantes en un solo archivo, sin necesidad de rastreo adicional. Esto es útil para sistemas RAG (Retrieval-Augmented Generation) y para agentes de código como Cursor o Cline que cargan contexto directamente.
Para la mayoría de sitios SEO, llms.txt es suficiente. llms-full.txt empieza a tener sentido si gestionas documentación técnica o si tu audiencia usa herramientas de IA para trabajar con tu producto.
Qué dicen los datos sobre llms.txt
Voy directo: los datos disponibles dicen que no mueve las citas de IA.
La evidencia más concluyente proviene del análisis de SE Ranking: entrenaron un modelo predictivo XGBoost sobre casi 300.000 dominios para medir qué factores influían en las citas generadas por IA. Al eliminar la variable de llms.txt, la precisión del modelo aumentó. Es decir, el archivo no aportaba ninguna señal útil, sino ruido estadístico.
Otros análisis independientes sobre adopción y rastreo llegan exactamente a la misma conclusión.
Adopción: cuántos sitios tienen uno
Depende del conjunto de datos. En el citado estudio de SE Ranking sobre casi 300.000 dominios (noviembre de 2025), solo el 10,13% tenía un archivo llms.txt. Es decir, prácticamente nueve de cada diez no lo tenían.
Otros estudios encontraron rangos similares:
- Trakkr: 13,3% de 37.894 dominios citados por IA (marzo 2026).
- Casey Burridge con datos de HTTP Archive: 5,61% de los 10.000 sitios principales (junio 2026).
- Semrush registró un crecimiento de 951 dominios en julio 2025 a 16.670 en septiembre 2026.
La curva de crecimiento es real. Pero 16.670 dominios sobre cientos de millones de sitios activos sigue siendo una fracción pequeña.
Un matiz importante: parte de esa adopción no es una decisión deliberada. CMSs como Wix, plataformas como Mintlify y GitBook, y plugins como Yoast SEO generan el archivo automáticamente. Que un dominio tenga llms.txt no significa necesariamente que alguien decidió tenerlo.
Por qué Google y Chrome dicen cosas contrarias
En mayo de 2026, la herramienta Lighthouse de Chrome (versión 13.3) añadió una comprobación de llms.txt en una nueva categoría llamada «Agentic Browsing». En la versión 13.5 (septiembre de 2026) pasó a un grupo de auditoría llamado «Agent Resource Discovery».
Diez días después de que Lighthouse 13.3 se publicara, Google Search Central hizo pública su posición oficial: Google Search no usa llms.txt, y crearlo no afectará positiva ni negativamente a la visibilidad en Search ni en sus funciones de IA.
Chrome comprueba si el archivo existe y Google Search dice que no lo usa. Ambas posturas son ciertas porque hablan de sistemas distintos: Chrome se enfoca en cómo los agentes de IA integrados en el navegador navegan por las webs, mientras que Search Central explica cómo Google recupera y posiciona contenido.
No interpretes la comprobación de Lighthouse como evidencia de que los rastreadores de Google leen tu archivo para decidir a quién citar.
¿ChatGPT, Claude y Gemini leen el tuyo?
Nadie fuera de esas empresas puede confirmarlo.
Lo que sí sabemos: OpenAI, Anthropic y Google publican sus propios archivos llms.txt para su documentación técnica. Eso demuestra que ven valor en el formato. Pero publicar uno es muy diferente a leer los de terceros como señal de citación.
Ninguna de las grandes plataformas de IA ha confirmado públicamente que llms.txt influya en qué páginas recuperan o mencionan en sus respuestas. El caso de uso más documentado hoy son los agentes de código, como Cursor o Cline, que cargan el llms.txt cuando se lo pasas como contexto a través de @Docs o un servidor MCP.
Cómo crear un archivo llms.txt paso a paso
Si decides añadirlo, se tarda menos de 30 minutos. El formato sigue la especificación oficial v2, actualizada en agosto de 2026.
La estructura es Markdown:
# Nombre de tu sitio o producto
> Una frase que resume de qué va tu sitio.

## Páginas principales
- [Página de producto](https://ejemplo.com/producto/): Qué hace tu producto principal
- [Precios](https://ejemplo.com/precios/): Planes y precios

## Artículos clave
- [Título de la guía](https://ejemplo.com/blog/guia/): De qué trata en una línea

## Opcional
- [Recurso secundario](https://ejemplo.com/recurso/): Contexto de menor prioridad
La sección ## Opcional es para contenido que un agente puede saltarse cuando necesita una ventana de contexto más corta.
Método 1: a mano (el más fiable)
Abre un editor de texto. Crea un archivo llamado llms.txt (en minúsculas). Sigue la estructura de arriba y súbelo al directorio raíz de tu servidor, el mismo lugar donde está tu robots.txt. Comprueba que es accesible en tudominio.com/llms.txt.
Pon entre 5 y 10 páginas como máximo. Una lista curada de tus páginas de producto, tus artículos más sólidos y tu página de contacto es más útil para un agente de IA que un volcado automático de 200 URLs.
Método 2: WordPress (Yoast o AIOSEO)
Si usas WordPress, tanto Yoast SEO como AIOSEO pueden generar el archivo. En Yoast: ve a Ajustes → Funcionalidades del sitio, baja hasta la sección de APIs y activa llms.txt.
El resultado es automático pero no estratégico: incluirá páginas que quizás no quieres destacar. Trátalo como un primer borrador y edítalo a mano.
Método 3: generadores para cualquier CMS
Para sitios que no son WordPress: Mintlify y GitBook lo generan automáticamente para documentación. Firecrawl puede crear un borrador a partir de tu sitemap para cualquier tecnología. Mismo aviso: revisa el resultado antes de publicar.
| Método | Control | Tiempo | Mantenimiento |
|---|---|---|---|
| A mano | Total | 20-30 min | Manual en cada actualización |
| Yoast / AIOSEO | Bajo | 2 min | Automático |
| Generadores | Medio | 10 min | Revisión manual |
Cómo queda un llms.txt bien hecho
La calidad supera a la cantidad. Un archivo con 8 páginas bien descritas es más útil para un agente de IA que una lista de 150 URLs sin contexto.
Qué incluir:
- Páginas de producto o servicio principales
- Tus artículos más sólidos y con más autoridad
- Página de precios
- Página sobre nosotros o quiénes somos
Qué dejar fuera:
- Páginas protegidas o que requieren login
- Contenido temporal (páginas de eventos, promociones limitadas)
- Páginas duplicadas o casi duplicadas
- Cualquier página que no quieras que un modelo de IA trate como canónica
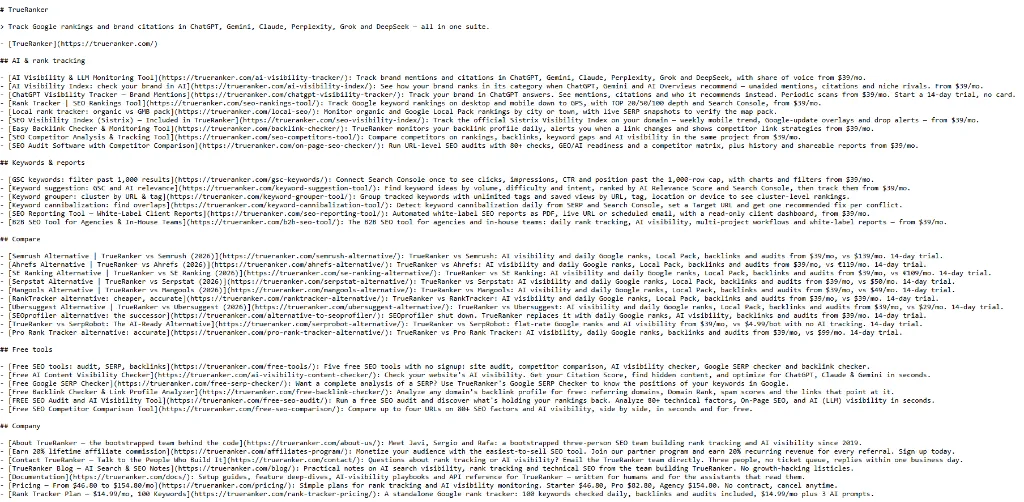
Puedes ver el archivo completo y cómo está estructurado en nuestro propio llms.txt en español.
¿Deberías añadir llms.txt a tu sitio?
No hay una respuesta universal. La pregunta útil es: ¿cuánto te cuesta mantenerlo?
Si tu CMS ya lo genera
Déjalo. Plataformas como Wix, Mintlify, GitBook, Yoast y AIOSEO lo crean automáticamente. Si el archivo existe sin coste para ti, mantenerlo tiene poco riesgo y puede ser útil a medida que crece la adopción. Solo asegúrate de que esté actualizado: el principal riesgo son las URLs obsoletas que dirigen a los agentes hacia contenido que ya no te interesa destacar.
Si tendrías que crearlo a mano
Aquí es donde se complica la justificación. Si crear y mantener el archivo implica auditar tu sitio, seleccionar URLs a mano, redactar descripciones y revisarlo cada vez que publicas o eliminas páginas, estarás dedicando un tiempo valioso a cambio de un retorno incierto.
Hay cosas con más impacto en las que centrarse primero: datos estructurados, enlazado interno, claridad del contenido, señales E-E-A-T. Mi guía de GEO las cubre en detalle si quieres un punto de partida.
Si te diriges a un agente de IA concreto
Este es el caso donde una implementación deliberada tiene más sentido. Si tu audiencia usa una herramienta de IA específica (sobre todo en documentación técnica o entornos de desarrollo), darle al sistema un mapa limpio de tu contenido puede ayudar de verdad. Que los agentes de código lean tu llms.txt a través de Cursor o Cline es un beneficio tangible y documentado hoy en día.
Trátalo como un experimento, no como un requisito. Lo que me lleva a la parte que nadie más cubre.
Cómo saber si llms.txt está haciendo algo en tu sitio
Todo el mundo explica qué es llms.txt y cómo crearlo. Nadie explica cómo medir si cambia algo. Eso es lo que quiero resolver aquí.
No lo juzgues comprobando unos pocos prompts a mano una semana después de publicarlo. Eso no te dice nada: los resultados de IA son inherentemente variables y una semana buena es puro ruido estadístico.
Empieza con un baseline antes de publicar el archivo.
Mide dónde apareces ahora en las respuestas generadas por IA: qué prompts mencionan tu marca, en qué motores de IA te citan, con qué frecuencia. Si ya estás midiendo tu visibilidad en IA en un rank tracker, exporta esos datos antes de hacer cualquier cambio.
Si estás empezando desde cero con el seguimiento de visibilidad en IA, esta guía explica el proceso paso a paso. Y antes de lanzar experimentos, conviene entender en qué se diferencia la visibilidad en IA de las posiciones en Google, ya que las métricas no evolucionan igual.
Deja pasar entre 4 y 6 semanas en condiciones estables.
No hagas un push masivo de contenido, no consigas 50 backlinks nuevos ni reescribas tus páginas más citadas durante la prueba. Aísla la variable todo lo que puedas.
Mantén un grupo de control de prompts.
Deben ser prompts en los que las URLs de tu llms.txt no sean directamente relevantes. Si tu visibilidad cambia por igual en ambos grupos, el archivo probablemente no es la causa.
Que un rastreador pida /llms.txt en los logs de tu servidor demuestra que el archivo fue solicitado, pero no que el sistema lo usara para elegir tu página o generar una cita. Lo que importa es si tu visibilidad real en IA cambia.
Eso te da una comparación antes-después con datos reales, en lugar de una intuición.
Preguntas frecuentes
¿Afecta llms.txt a mis posiciones en Google?
No. El archivo está dirigido a rastreadores y agentes de IA, no a los crawlers de motores de búsqueda tradicionales. Los datos de log de Googlebot confirman que no solicita el archivo llms.txt (cero peticiones en el análisis de logs de Nathan Hall sobre siete sitios). Por tanto, no hay ningún impacto en tus posiciones por tenerlo o no.
¿Cuántos enlaces debería poner en mi llms.txt?
Apunta a entre 5 y 10 enlaces seleccionados con criterio. Deben representar el núcleo de tu sitio: tus páginas de producto más sólidas, tus artículos más relevantes y tu página de contacto o sobre nosotros. Una lista corta y curada es más útil para un agente de IA que un volcado automático de tu sitemap.
¿Debería marcar llms.txt como noindex en Google?
Sí, es una buena práctica. El archivo es una instrucción para sistemas de IA, no contenido que quieras ver en los resultados de Google. Una directiva noindex evita que se indexe mientras los rastreadores de IA siguen pudiendo encontrarlo y leerlo (rastrear e indexar son dos procesos distintos).
¿Puedo usar llms.txt para bloquear el entrenamiento de modelos de IA?
No. llms.txt está pensado para guiar a los agentes de IA durante la inferencia (cuando responden a una pregunta de un usuario), no para controlar los datos de entrenamiento. Si quieres excluirte del entrenamiento de IA, usa robots.txt con directivas como User-agent: GPTBot seguido de Disallow: /. Esa es la herramienta adecuada para eso.
¿Mejora llms.txt las citas en ChatGPT o Gemini?
No de forma demostrable, según los datos disponibles. El análisis de SE Ranking sobre 300.000 dominios no encontró ninguna relación entre tener un llms.txt y la frecuencia de citas. John Mueller de Google ha insistido en el podcast Search Off the Record en que un buscador no puede apoyarse en un archivo autodeclarado para diferenciar sitios web. La base de evidencias sigue creciendo: si lo implementas, mídelo en lugar de dar por hecho que funciona.
¿Qué pasa si no actualizo mi llms.txt?
El principal riesgo son las URLs caducadas. Si tu archivo apunta a agentes de IA hacia páginas que has eliminado, reestructurado o que ya no consideras autoritativas, los estás dirigiendo hacia contenido que no te representa bien. Si lo publicas, añade un recordatorio en el calendario para revisarlo cada vez que hagas cambios significativos en la arquitectura de tu sitio o en tus páginas más importantes.
¿Sabes cuánto te mencionan ChatGPT, Gemini y Perplexity?
Mide tu visibilidad en IA y detecta cuándo algo la mueve de verdad.
Escrito por
Javier Quevedo
Cofundador y CEO, Lead SEO
Javier cofundó TrueRanker y lidera el frontend, la web pública y el último tramo entre un ranking en la base de datos y la pantalla que usa un SEO. Lleva años convirtiendo GEO, SEO local, on-page y visibilidad en IA en producto — y en las guías de este blog — para que las agencias midan las citas de ChatGPT igual que ya miden Google. También trabaja el backend: una interfaz limpia sobre datos viejos sigue siendo una mentira.
Te puede interesar
La checklist de optimización IA que aplico antes de hacer cambios en una página.
Con esta checklist de optimización IA coges un prompt, miras si te citan o te nombran y compruebas si editar la página sirvió de algo.
Javier Quevedo10 min de lectura
Leer el artículoLos factores de ranking en búsquedas con IA solo cuentan si consigues que te citen.
Si una página sale citada en ChatGPT o Perplexity y otra no, la causa son los factores de ranking en búsquedas con IA. Te cuento qué miro en un prompt.
Javier Quevedo13 min de lectura
Leer el artículoPor qué tu posición en Google no dice nada de tu visibilidad en IA
Ser el #3 en Google no te mete en la respuesta de ChatGPT. Por qué se han separado y qué medir en su lugar.
TrueRanker2 min de lectura
Leer el artículo¿Qué es el Monitoreo de Marca en IA? (Y por qué es crucial en 2026)
Qué es el monitoreo de marca en IA, en qué se diferencia del SEO y cómo medir menciones, citas y share of voice.
Javier Quevedo7 min de lectura
Leer el artículoShare of Voice en IA: Cómo saber si ChatGPT recomienda a tu competencia [2026]
Mide tu share of voice en ChatGPT y Gemini frente a rivales y lee qué dicen los LLMs de tu marca.
Javier Quevedo4 min de lectura
Leer el artículoMenciones vs Citas en IA: La métrica clave del GEO [2026]
Salir en una respuesta de IA no es un objetivo binario. Aprende la diferencia entre una Mención de Marca y una Cita, y por qué debes medir ambas.
Javier Quevedo5 min de lectura
Leer el artículo