Les facteurs de visibilité IA ne comptent que si vous êtes cité.
Si un concurrent est cité par ChatGPT à votre place, c’est là qu’entrent en jeu les facteurs de visibilité IA. Voici ce que je vérifie sur un prompt.

Ça vous est déjà arrivé. Vous êtes en première page d’une requête commerciale, vous collez cette requête dans ChatGPT, et la réponse parle d’un concurrent.
Si un concurrent est cité par ChatGPT à votre place, c’est là qu’entrent en jeu les facteurs de visibilité IA. Ce n’est pas une copie secrète des systèmes de ranking de Google, et ce n’est pas un score avec des décimales qu’on publie quelque part.
Pour qu’un assistant utilise votre page, il faut qu’il la trouve, qu’il s’y fie, et qu’il vous nomme ou qu’il cite vraiment l’URL.
Si l’on vous nomme sans URL, vous gagnez de la visibilité de marque. Si l’on vous cite, vous pouvez emporter le clic.
Les facteurs de visibilité IA concernent les citations, pas les liens bleus
Les facteurs de visibilité IA sont les raisons pour lesquelles un modèle génératif met votre URL derrière une réponse, pas les raisons pour lesquelles vous apparaissez dans les liens bleus.
La recherche classique renvoie une liste ordonnée. Vous pouvez être 3e et quand même recevoir des visites. Un assistant écrit une réponse. Soit votre page est dans les quelques sources qu’il a utilisées, soit elle n’y est pas. Il n’y a pas de page deux.
Un SEO est 2e sur « meilleur outil de suivi de positions pour agences ». Il pose la même question à ChatGPT. Le modèle nomme un concurrent et cite un comparatif. Sur Google, vous n’avez pas perdu de positions. Ce qui a manqué, c’est la citation.
C’est pour ça que je les traite comme les conditions pour sortir comme source, pas comme un classement que vous exportez de Search Console.
Google ne dit pas comment ses AI Overviews choisissent de vous citer
Google ne publie pas comment il choisit qui citer dans un AI Overview. Ce qu’il publie, ce sont les systèmes de ranking qu’il utilise déjà dans la Recherche : BERT, RankBrain, passage ranking, MUM, fraîcheur, analyse des liens.
Ces systèmes expliquent comment Google trouve et ordonne des documents. Ils ne disent pas si votre URL apparaîtra en citation dans un Overview.
Si quelqu’un vous vend « la liste officielle des facteurs d’AI Overview », il l’a inventée. Voici ce sur quoi vous pouvez vraiment travailler :
- La page doit être indexée et crawlable, sinon le modèle ne la trouve pas.
- Le passage doit répondre à la requête, sinon le passage ranking n’a rien d’utile à extraire.
- La page doit sembler une source qui mérite d’être citée, sinon l’Overview citera quelqu’un d’autre même si vous êtes mieux placé.
Une landing commerciale trop légère peut gagner les liens bleus pendant que l’Overview cite une page de documentation qui n’a jamais été dans le top 3. Être bien placé n’a rien changé à la citation.
Pourquoi un classement Google ne dit rien de votre visibilité IA est la version longue. Dans cet article, il y a environ 400 requêtes commerciales. Avec cet échantillon, on ne planifie pas un trimestre.
Sept facteurs de visibilité IA que je vérifie pour un prompt donné
Sept facteurs de visibilité IA couvrent ce que je peux vraiment contrôler sur un prompt : les premières lignes, mention contre citation, la même entreprise, un bloc que l’on peut copier, une liste actuelle, que le modèle voie la page, et que l’on vous nomme dans des sources qu’il utilise déjà.
Je ne leur mets pas une note sur 100. Je demande lequel a échoué sur cette requête.
| Facteur | Ce que ça change dans la réponse | Comment le vérifier sur un prompt |
|---|---|---|
| Si les premières lignes répondent au prompt | Si le modèle prend votre URL en compte | Le premier écran de votre page répond-il au prompt tel qu’il a été posé ? |
| Être nommé n’est pas une citation | Si le lecteur peut cliquer | Nom de marque dans le texte, contre une URL en dessous |
| Que le modèle vous reconnaisse comme la même entreprise | Si le modèle vous traite comme la même entreprise d’une page à l’autre | Même nom, même offre, assez de contenu pour paraître une source |
| Un bloc que le modèle peut copier | Si le modèle peut reprendre un passage sans tout réécrire | Réponse directe, puis liste ou tableau, puis les nuances |
| Si le prompt demande une année ou une liste actuelle | Si une page de l’an dernier sert encore | Le prompt implique-t-il une année, un prix ou une liste actuelle ? |
| Que le modèle puisse voir la page | Si la page entre dans les sources utilisées | Indexée, pas bloquée, pas un Soft 404 |
| Que l’on vous nomme dans des sources déjà utilisées | Si le modèle vous a trouvé sur des pages auxquelles il fait déjà confiance | Êtes-vous dans les comparatifs et les docs qu’il utilise vraiment ? |
Un article de 2023 sur l’optimisation pour moteurs génératifs a testé des tactiques d’écriture — citations entre guillemets, statistiques, sources sur la page — et montré qu’elles peuvent changer la fréquence à laquelle un modèle choisit une source. Je m’en sers comme piste d’écriture, pas comme une liste que je prouve avec un prompt.
Si les premières lignes ne répondent pas au prompt, le modèle vous ignore
La page doit répondre à ce qu’on demande, dans un langage proche de la question, avant le texte commercial.
Si le prompt est « meilleur outil de suivi de positions pour une agence de cinq personnes » et que votre H1 est un slogan de marque, le modèle peut vous ignorer. Les assistants extraient des passages, pas des slogans.
J’ouvre l’URL, je lis les 100 premiers mots et je me demande : est-ce que ce paragraphe irait dans la réponse ? Si vous ne l’incluiez pas dans la réponse, le modèle ne le fera pas non plus.
Être nommé n’est pas une citation : il faut l’URL
Une citation, c’est un lien vers votre page. Une mention, c’est le modèle qui dit votre nom dans la phrase.
ChatGPT peut vous nommer et envoyer le clic vers un article G2. Perplexity peut vous citer et à peine dire la marque. Ce n’est pas le même résultat. Si vous mélangez les deux dans un seul chiffre de « visibilité IA », vous ne voyez plus ce qui a échoué.
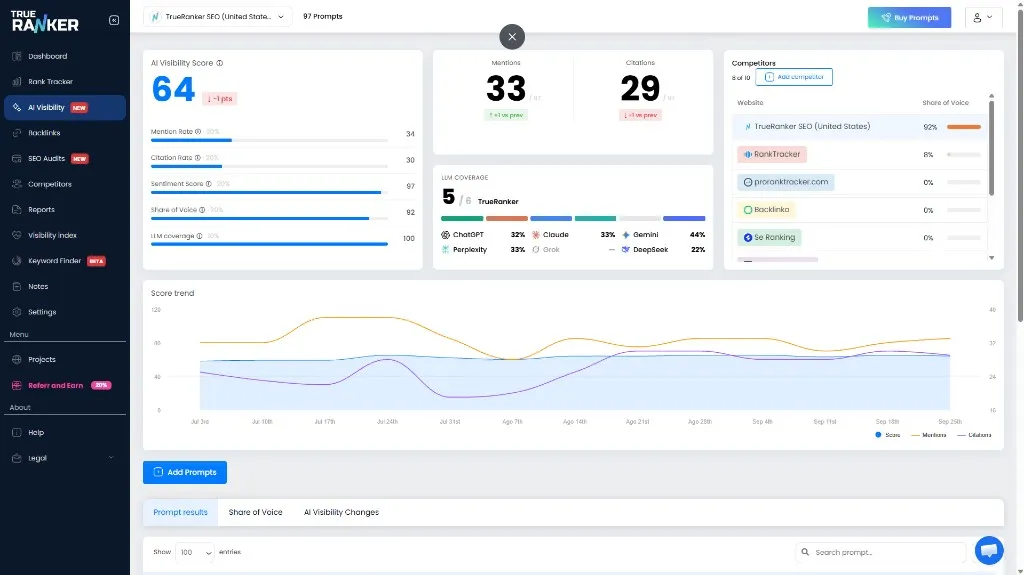
Mentions et citations, ce sont deux comptes. Un seul score de visibilité ne dit pas si l’on vous a nommé ou si l’on a mis l’URL.
Sur un prompt, pour moi c’est bon quand l’URL est dans les sources, pas quand le texte se contente de vanter vos mérites.
Le modèle doit vous reconnaître comme la même entreprise
Le modèle doit vous voir comme la même entreprise et le même produit sur les pages qu’il trouve. Et il doit y avoir assez de contenu pour paraître une source, pas un site one-page.
Si la page d’accueil dit « plateforme de visibilité IA », la documentation dit « suivi de positions » et le blog dit « outil pour les assistants », vous lui avez donné trois entités. Il prendra celle qu’il a déjà claire — souvent un concurrent.
Je cherche un nom, un métier et un ensemble de pages qui répondent aux questions voisines. Un site one-page ne fera pas le poids face à un prompt de comparaison.
Mettez la réponse dans un bloc que le modèle peut copier
Commencez par une phrase directe, enchaînez avec une liste ou un tableau, et gardez les nuances pour la fin. Les modèles citent des blocs qu’ils peuvent reprendre sans réécrire toute la landing.
Un essai de 2 000 mots avec la réponse au neuvième paragraphe perd face à une page de 700 qui met la réponse en premier. Ce n’est pas la longueur qui gagne. C’est le bloc que l’on peut copier.
Quand vous réécrivez une page pour ça, placez l’affirmation dans les deux premières phrases de la section qui répond à cette question, puis les puces. S’il y a une métaphore, à la fin — ou vous la retirez.
Si le prompt demande une année ou une liste actuelle, mettez la page à jour
La date de la page compte si le prompt demande une liste actuelle, une année, un prix ou un « maintenant ». Sur une définition qui n’a pas changé, ça compte à peine.
« Meilleur CRM pour dentistes 2026 » demande une date. « Qu’est-ce qu’une citation dans ChatGPT » n’en demande pas. J’actualise la première et je laisse la seconde.
Je regarde la ligne de mise à jour que le lecteur voit, et si les faits de la page collent encore à ce que disent les modèles ce mois-ci. Un tableau comparatif périmé laisse le champ libre au concurrent qui a publié la semaine dernière.
Le modèle doit pouvoir voir la page
L’URL doit être indexée, crawlable, et pas un Soft 404. Si le modèle n’arrive pas jusqu’au document, le reste ne compte plus.
Certains SEO peaufinent le schema FAQ d’une URL que site: ne renvoie pas. Le modèle ne peut pas citer une page que Google n’a pas indexée.
Noindex, un blocage robots, un canonical vers ailleurs, un mur de connexion : n’importe lequel de ces points vous sort du jeu avant qu’on regarde le contenu.
Sur les « meilleur X », le modèle lit d’abord les listes
Sur les prompts « meilleur X », le modèle lit souvent d’abord des sources auxquelles il fait déjà confiance — documentation, comparatifs, listes — et n’ouvre pas votre landing.
Vous pouvez être 1er sur Google et perdre la réponse si vous n’êtes pas dans les trois listes qu’il utilise. Pour la recherche IA, le travail de liens, c’est être nommé dans ces sources, pas empiler un lien de plus vers la page d’accueil.
Je ne le traite pas comme « les backlinks comptent encore, comme en 2014 ». Je regarde quelles URLs ce prompt cite, et si vous y êtes.
Chaque modèle choisit les sources à sa façon
ChatGPT, Perplexity, Gemini et les AI Overviews de Google ne trouvent pas les sources de la même manière, ne citent pas à la même fréquence, et ne tomberont pas d’accord sur le même prompt.
Je n’invente pas de formule. Je regarde ce que vous pouvez observer, sans faire semblant qu’OpenAI ou Google en ait publié une :
- Perplexity cite beaucoup. Si vous n’apparaissez jamais comme source là-bas, le nombre de fois où ChatGPT vous nomme ne vous dit rien.
- ChatGPT nomme des marques dans le texte et cite autre chose. C’est le piège mention contre citation.
- Gemini et les AI Overviews de Google sont plus proches de l’index Google. Si vous n’êtes pas indexé, c’est là que ça se voit d’abord.
- Le même prompt, la même semaine : un modèle vous cite et un autre vous ignore. Ce n’est pas du bruit. C’est pour ça que je n’optimise pas un score qui mélange les modèles.
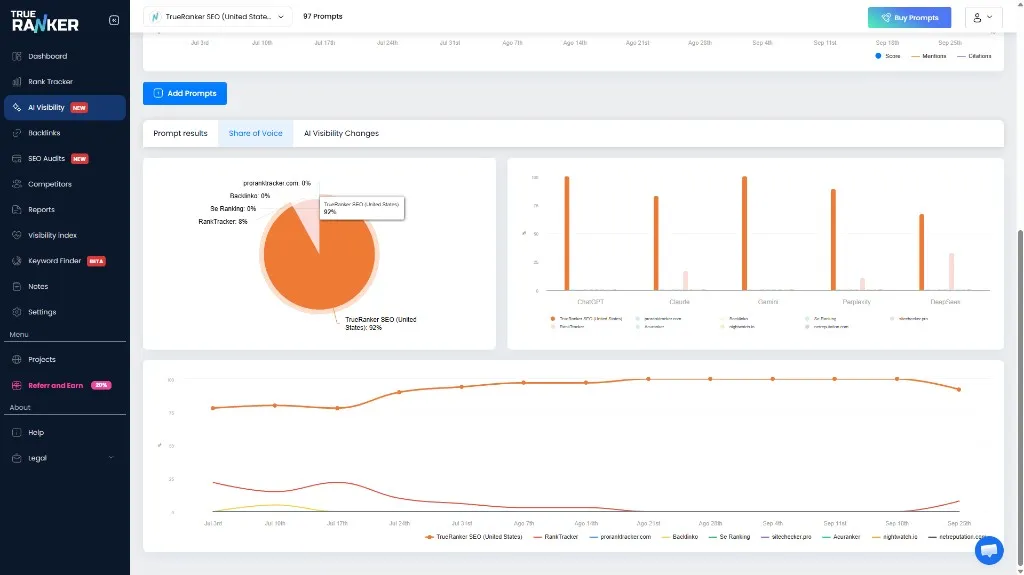
La part de voix n’est pas la même d’un modèle à l’autre.
Si vous ne testez que ChatGPT, vous devinez le reste.
Commencez par l’URL visible, pas par le schema
D’abord ce qui fait que le modèle ne vous voit même pas. Ensuite, passer d’une mention à une citation. Je ne commencerais pas par le schema.
Ordre que j’utiliserais sur une page cette semaine :
- Le modèle peut-il voir l’URL ? Indexée, 200, sans un canonical qui vous écarte.
- Le premier écran répond-il au prompt ? Les premières lignes avant le texte de marque.
- L’échec, c’est une mention ou une URL absente ? Ne réécrivez pas tout le site pour un problème de nom.
- Peut-on copier un passage ? Réponse, liste, nuances.
- Le prompt demande-t-il une année ou une liste actuelle ? Actualisez la liste si c’est le cas ; laissez le glossaire si ce n’est pas le cas.
- Y a-t-il une confusion d’entités ? Alignez le nom et le métier dans le cluster.
- Quelles pages tierces ce prompt cite-t-il déjà ? Il faut y figurer, ou écrire la page que le modèle préférerait citer plutôt qu’un comparatif.
Le schema aide les machines qui le lisent. À lui seul, il ne transforme pas un prompt « nomme un concurrent » en « cite notre URL ».
En 2026, un top 10 Google ne dit plus si l’on vous cite
En 2026, un top 10 Google ne dit plus si l’on va vous citer en recherche IA. Ça prédit moins qu’avant, et ce n’était déjà pas une garantie.
Je veux toujours que la page se positionne. Il faut un crawl, une vraie réponse, et un site déjà cité ailleurs. L’erreur, c’est de traiter la 3e position comme le même travail que « ChatGPT a utilisé cette URL ».
Je m’appuie sur Pourquoi un classement Google ne dit rien de votre visibilité IA : environ 400 requêtes commerciales, et la position Google servait trop peu pour savoir si le modèle nommait la marque. Je ne vais pas coller le pourcentage 2026 d’un comparatif que je ne peux pas citer.
En pratique, ce que vous mesurez n’est plus la même chose. Vous n’exportez pas vos mots-clés dans un tableau de bord IA. Vous suivez les mêmes prompts métier et vous regardez si l’URL citée est la vôtre.
Comment voir quel facteur de visibilité IA a échoué sur un prompt
Vous partez d’un seul prompt, vous le lancez dans plusieurs modèles, et vous notez mention et URL citée à part. Une note IA pour tout le domaine ne vous le dit pas.
C’est précisément l’étape que les classements tout faits négligent. Ils notent le domaine. Moi, je note une question.
Choisissez un prompt qu’un client taperait vraiment : « meilleur outil de suivi de positions pour agences », pas le nom de votre marque. Lancez-le dans ChatGPT, Perplexity, Gemini, et dans l’AI Overview de Google s’il s’affiche.
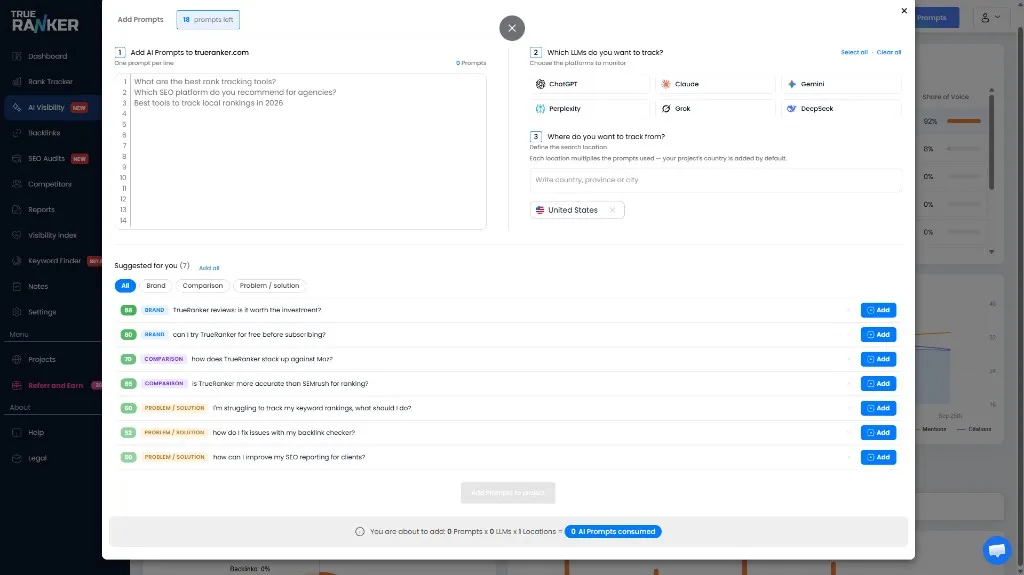
Le même prompt, les modèles qui vous importent, un pays.
Sur chaque modèle, deux annotations :
- Mention : le texte vous nomme-t-il ?
- Citation : votre URL est-elle dans les sources ?
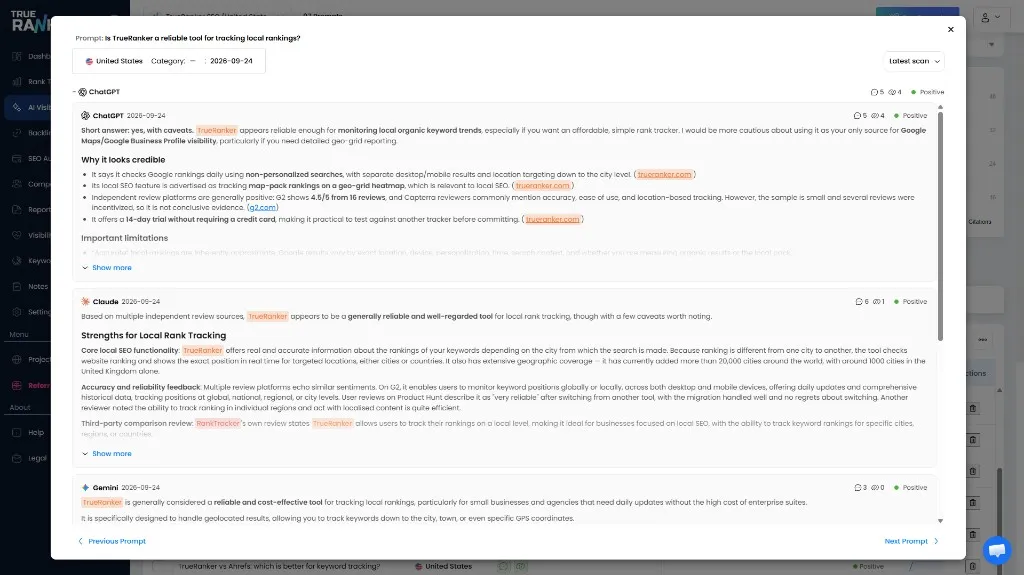
Dans la réponse enregistrée, surlignez la marque, puis cherchez votre URL.
Ensuite, vous reliez l’échec à un facteur :
- Pas de mention, pas de citation, et
site:ne renvoie pas l’URL → le modèle ne la voit pas. - Pas de mention, la page existe, le premier écran ne répond pas au prompt → premières lignes.
- On vous nomme dans la phrase, le comparatif est dans les sources → citation contre mention, et souvent vous n’êtes pas dans les listes.
- On vous citait le mois dernier, plus ce mois-ci, le prompt porte une année → fraîcheur.
- On vous cite dans Perplexity, invisible dans ChatGPT → différence de modèle, pas un Core Web Vital en échec.
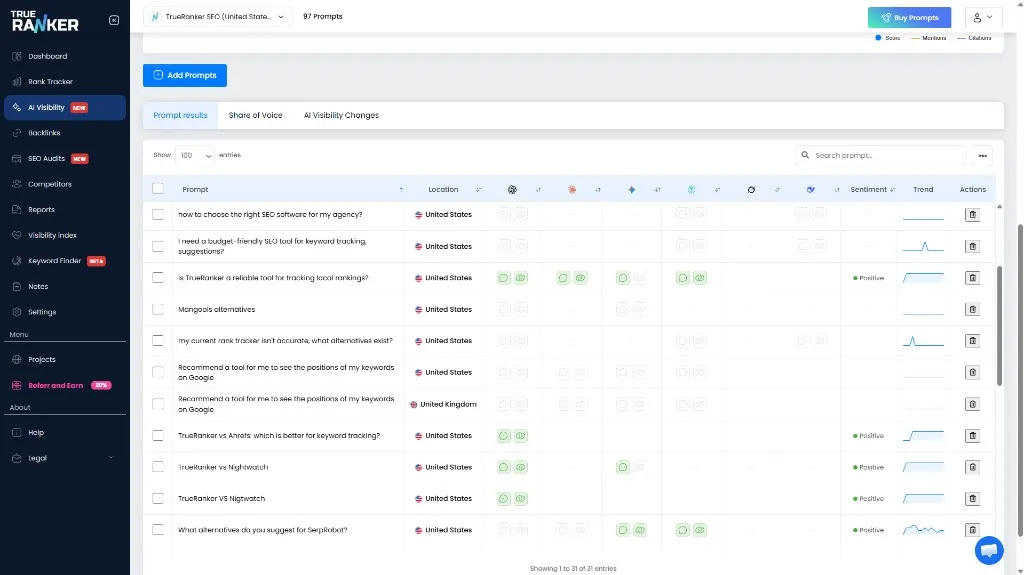
Mention contre citation, modèle par modèle, sur les mêmes prompts.
Si vous voulez ce contrôle de manière régulière, sans avoir à rafraîchir un onglet manuellement, suivez ce prompt dans ChatGPT. Mentions et citations sont dans des colonnes séparées. La vue des six modèles est dans le suivi de visibilité IA.
Questions fréquentes
Que sont les facteurs de visibilité IA ?
Ce sont les conditions pour que ChatGPT, Perplexity, Gemini ou un AI Overview de Google utilisent votre page comme source. Ce ne sont pas les systèmes de ranking de Google recopiés dans un autre tableau.
Faut-il être premier sur Google pour être cité ?
Non. Les Overviews et les réponses de chat sortent souvent des pages qui ne sont pas dans le top 3. Il faut en revanche que le modèle puisse voir la page. Se positionner aide. Ça ne garantit pas la citation.
ChatGPT, Perplexity et Gemini citent-ils de la même façon ?
Non. Perplexity cite davantage. ChatGPT vous nommera et citera quelqu’un d’autre. Gemini et les AI Overviews sont plus proches de l’index Google. Lancez le même prompt dans plus d’un modèle avant de décider quoi corriger.
Le balisage schema décide-t-il si vous êtes cité ?
Le schema peut rendre la page plus facile à lire pour une machine. À lui seul, il ne décide pas une citation. Ce qui compte davantage, ce sont les réponses directes, que le modèle voie l’URL, et que vous soyez dans les sources qu’il lit déjà.
Comment savoir quel facteur de visibilité IA a vraiment échoué ?
Lancez à nouveau un prompt et notez mention contre URL citée, modèle par modèle, après le changement. Si la mention apparaît et que l’URL ne sort toujours pas, vous n’avez pas corrigé le facteur de citation. Un score de visibilité qui mélange les deux le cache.
Voyez quels modèles vous citent, et lesquels se contentent de vous nommer.
Suivez le même prompt dans ChatGPT et dans les autres modèles. Mentions et citations sont dans des colonnes séparées, pour voir quel facteur a vraiment échoué.
Écrit par
Javier Quevedo
Cofondateur & CEO, SEO Lead
Javier a cofondé TrueRanker et dirige le frontend, le site public et le dernier kilomètre entre un ranking en base et l’écran qu’un SEO utilise vraiment. Depuis des années, il transforme GEO, SEO local, on-page et visibilité IA en produit — et en guides sur ce blog — pour que les agences mesurent les citations ChatGPT comme elles mesurent déjà Google. Il travaille aussi le backend : une interface propre sur des données périmées reste un mensonge.
Cela pourrait vous intéresser
La checklist d’optimisation pour la recherche IA que je passe avant de modifier une page.
Avec la checklist d’optimisation pour la recherche IA, vous prenez un prompt, voyez citation ou mention, et si modifier la page a servi à quelque chose.
Javier Quevedo11 min de lecture
Lire l’articlePourquoi votre classement Google ne dit rien de votre visibilité IA
Être 3e sur Google ne vous met pas dans la réponse de ChatGPT. Pourquoi les deux ont divergé et quoi mesurer à la place.
TrueRanker3 min de lecture
Lire l’article