Ranking-Faktoren in der KI-Suche zählen erst, wenn sich das Zitat ändert.
Warum eine Seite in ChatGPT oder Perplexity zitiert wird und eine andere nicht: Ranking-Faktoren in der KI-Suche – und was ich an einem Prompt prüfe.

Das kennst du. Du stehst auf Seite eins für eine kommerzielle Anfrage, kopierst sie in ChatGPT – und ein Wettbewerber liefert die Antwort.
Ranking-Faktoren in der KI-Suche sind die Gründe dafür. Sie sind keine geheime Kopie der Google-Ranking-Systeme und kein Score mit Dezimalstellen, den jemand veröffentlicht.
Damit ein Assistent deine Seite nutzt, muss er sie finden, ihr vertrauen und dich entweder nennen oder die URL wirklich zitieren.
Nur genannt zu werden ist Markenbekanntheit. Zitiert zu werden ist der Klick.
Was Ranking-Faktoren in der KI-Suche sind
Ranking-Faktoren in der KI-Suche sind die Gründe, warum ein generatives Modell deine URL hinter eine Antwort stellt – nicht die Gründe, warum du in den blauen Links rankst.
Klassische Suche liefert eine sortierte Liste. Du kannst auf Platz drei stehen und trotzdem Sichtbarkeit haben. Ein Assistent schreibt eine Antwort. Entweder deine Seite liegt in dem kleinen Satz Quellen, den er genutzt hat – oder nicht. Es gibt keine Seite zwei.
Ein SEO rankt auf Platz zwei für „bester Rank-Tracker für Agenturen“. Er stellt dieselbe Frage an ChatGPT. Das Modell nennt einen Wettbewerber und zitiert ein Round-up. Das Ranking ist nicht gescheitert. Die Zitat-Aufgabe schon.
Deshalb behandle ich das als Bedingungen für die Quellenauswahl, nicht als ein Ranking, das du aus der Search Console exportierst.
Google veröffentlicht keine Gewichtsliste für KI-Zitate
Es gibt keine veröffentlichte Gewichtsliste dafür, wer in Google AI Overviews zitiert wird. Google veröffentlicht Ranking-Systeme, die schon unter der normalen Suche stehen: BERT, RankBrain, Passage Ranking, MUM, Freshness, Link-Analyse.
Diese Systeme erklären, wie Google Dokumente abruft und sortiert. Sie sagen dir nicht, mit welcher Wahrscheinlichkeit deine URL in einem Overview als Quelle erscheint.
Wer dir „die offizielle AI-Overview-Faktorenliste“ verkauft, hat sie erfunden. Worauf du wirklich bauen kannst:
- Die Seite muss indexiert und crawlbar sein, sonst sieht Retrieval sie nicht.
- Der Abschnitt muss die Anfrage beantworten, sonst hat Passage Ranking nichts Brauchbares.
- Die Quelle muss zitierwürdig wirken, sonst zitiert das Overview jemand anderen, obwohl du höher rankst.
Eine dünne Sales-Landing kann die blauen Links gewinnen, während das Overview eine Doku-Seite zitiert, die nie in den Top drei stand. Position überträgt sich nicht.
Der längere Text zu Google-Ranking versus KI-Sichtbarkeit (etwa 400 kommerzielle Anfragen in dem Post) zeigt, wie schwach die Korrelation für die Quartalsplanung ist.
Sieben Ranking-Faktoren, die ich an einem Prompt prüfe
Sieben Ranking-Faktoren decken ab, was ich an einem Prompt wirklich prüfen kann: Match, Zitat versus Erwähnung, Entity, Struktur, Freshness, Erreichbarkeit und Bestätigung durch Dritte.
Ich vergebe keine Note von 1 bis 100. Ich frage: welcher dieser Punkte ist an diesem Prompt gescheitert?
| Faktor | Was sich in der Antwort ändert | So prüfst du es an einem Prompt |
|---|---|---|
| Query-Match | Ob Retrieval deine URL überhaupt in Betracht zieht | Beantwortet der erste Bildschirm deiner Seite den Prompt so, wie gefragt wurde? |
| Zitat, nicht nur Erwähnung | Ob der Leser durchklicken kann | Markenname im Fließtext versus URL darunter |
| Entity-Konsistenz und Tiefe | Ob das Modell dich über Seiten hinweg als dieselbe Firma sieht | Gleicher Name, gleiches Angebot, genug Inhalt für eine Quelle |
| Struktur, die man übernehmen kann | Ob ein Abschnitt extrahierbar ist | Direkte Antwort, dann Liste oder Tabelle, dann der Hinweis |
| Freshness bei datierten Anfragen | Ob die Seite vom letzten Jahr noch genutzt wird | Fordert der Prompt ein Jahr, einen Preis oder eine aktuelle Shortlist? |
| Erreichbarkeit | Ob die Seite überhaupt in den Satz kommt | Indexiert, nicht blockiert, kein Soft 404 |
| Bestätigung durch Dritte | Ob das Modell dich in Quellen findet, denen es schon vertraut | Stehst du in den Round-ups und Docs, die es wirklich abruft? |
Ein Paper von 2023 zu Generative Engine Optimization hat Schreibtaktiken getestet – Zitate, Statistiken, Quellenangaben auf der Seite – und gezeigt, dass sie die Häufigkeit der Quellenauswahl verändern können. Ich sehe das als Schreibexperiment, nicht als bewiesene Rangliste aus einem Prompt.
Query-Match: Die Seite muss in den ersten Zeilen antworten
Query-Match heißt: Die Seite formuliert die Antwort, die der Prompt verlangt, in Sprache nahe an der Frage – bevor der Pitch kommt.
Ist der Prompt „bester Rank-Tracker für eine Fünf-Personen-Agentur“ und dein H1 ein Markenslogan, kann Retrieval dich überspringen. Assistenten extrahieren Passagen, keine Slogans.
Ich öffne die URL, lese die ersten 100 Wörter und frage: Würde ich diesen Absatz in die Antwort einfügen? Wenn nicht, tut es das Modell vermutlich auch nicht.
Ein Zitat ist nicht dasselbe wie eine Markenerwähnung
Ein Zitat ist eine klickbare Quelle. Eine Erwähnung ist, dass das Modell deinen Namen im Satz sagt.
ChatGPT kann dich nennen und den Klick trotzdem an einen G2-Artikel schicken. Perplexity kann dich zitieren und die Marke kaum aussprechen. Das sind verschiedene Ergebnisse. Wer beides in eine „KI-Sichtbarkeit“-Zahl mischt, versteckt den Fehler.
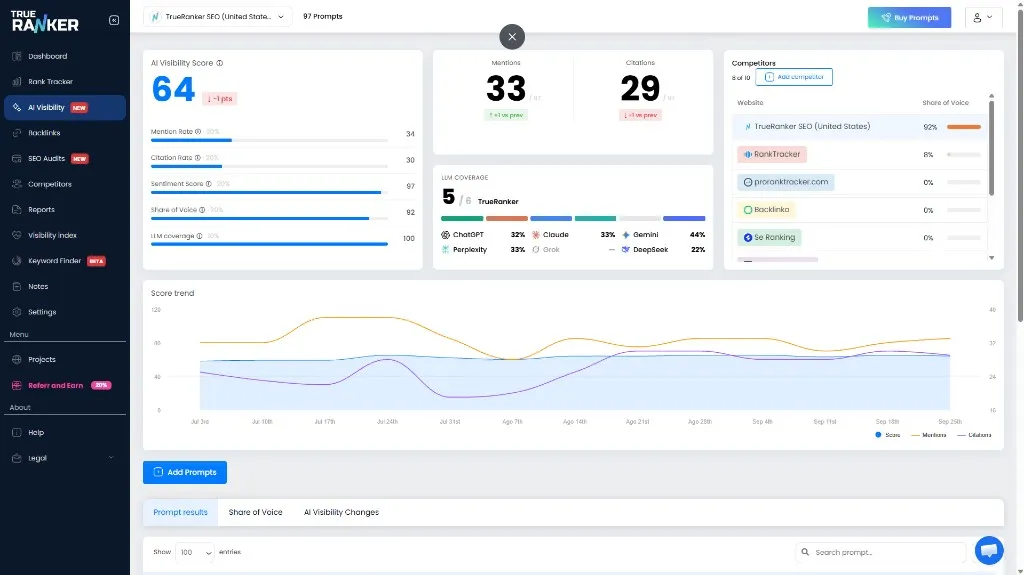
Erwähnungen und Zitate sind zwei Zähler. Ein einzelner Sichtbarkeits-Score verrät nicht, welcher gewechselt hat.
Ausführlicher geht es um Erwähnung versus Zitat in KI-Antworten. An einem Prompt gilt der Faktor für mich als bestanden, wenn deine URL in der Quellenliste steht – nicht wenn der Text schmeichelhaft ist.
Entity-Konsistenz und thematische Tiefe
Entity-Konsistenz heißt: Das Modell erkennt dich als dieselbe Firma mit demselben Produkt auf den Seiten, die es abruft. Thematische Tiefe heißt: genug Inhalt, um wie eine Quelle zu wirken – nicht wie ein One-Pager.
Sagt die Homepage „KI-Sichtbarkeits-Plattform“, die Doku „Rank-Tracker“ und der Blog „GEO-Tool“, hast du dem Modell drei Entitäten gegeben. Es wählt die, zu der es schon einen sauberen Datensatz hat – oft einen Wettbewerber.
Ich suche einen Namen, einen Job und einen Cluster von Seiten, die verwandte Fragen beantworten. Ein One-Pager überlebt keinen Vergleichs-Prompt.
Struktur, die eine Antwort übernehmen kann
Struktur heißt: ein direkter Einstiegssatz, dann Liste oder Tabelle, dann der Hinweis. Modelle zitieren Blöcke, die sie übernehmen können, ohne deine ganze Landing umzuschreiben.
Ein Essay mit 2.000 Wörtern und der Antwort in Absatz neun verliert gegen eine Seite mit 700 Wörtern, die die Antwort zuerst stellt. Länge ist nicht der Faktor. Extrahierbarkeit ist es.
Wenn du dafür umschreibst: Behauptung in den ersten zwei Sätzen des Abschnitts, den der Prompt trifft, dann die Bullets. Metapher ans Ende – oder weg.
Freshness, wenn die Anfrage datiert ist
Freshness zählt, wenn der Prompt eine aktuelle Shortlist, ein Jahr, einen Preis oder ein „jetzt“ impliziert. Bei einer Definition, die sich nicht bewegt hat, kaum.
„Bester CRM für Zahnärzte 2026“ ist datiert. „Was ist ein Zitat in ChatGPT“ nicht. Die erste Seite aktualisieren, die zweite in Ruhe lassen – das ist die richtige Trennung.
Ich schaue auf das sichtbare Aktualisierungsdatum und ob die Fakten noch zu dem passen, was die Modelle diesen Monat sagen. Eine veraltete Vergleichstabelle ist ein Geschenk an den, der letzte Woche publiziert hat.
Die Seite muss erreichbar sein
Erreichbarkeit heißt: URL indexiert, crawlbar, kein Soft 404. Sieht Retrieval das Dokument nicht, stimmen die anderen Faktoren nicht ab.
Leute polieren FAQ-Schema auf einer URL, die site: nicht zurückgibt. Das Modell kann keine Seite zitieren, die Google nie geholt hat.
Noindex, Robots-Block, Canonical woanders, Login-Wall: jedes davon beendet die Aufgabe, bevor „Ranking-Faktoren“ anfangen.
Bestätigung durch Dritte
Bestätigung durch Dritte heißt: Das Modell findet dich auf Seiten, denen es schon vertraut – Docs, Vergleichsartikel, seriöse Listen. Bei „bestes X“-Prompts liest es die oft zuerst und öffnet deine Landing gar nicht.
Du kannst auf Platz eins stehen und die Antwort trotzdem verlieren, wenn du in den drei Listicles fehlst, die das Modell mag. Linkbuilding für KI-Suche heißt für mich oft: in den Quellen genannt werden, die Modelle abrufen – nicht der nächste Homepage-Link.
Ich behandle das nicht als „Backlinks zählen wie 2014“. Ich schaue: Welche URLs zitiert dieser Prompt – und stehst du darauf?
Jede KI-Plattform hat ihre eigene Quellenlogik
Ranking-Faktoren sind keine einzige Liste. ChatGPT, Perplexity, Gemini und Google AI Overviews rufen unterschiedlich ab, zitieren unterschiedlich oft und widersprechen sich im selben Prompt.
Ich erfinde keine Gewichtstabelle. Ich schaue, was du ohne Lab-Geheimnisse beobachten kannst:
- Perplexity zitiert viel. Wenn du dort nie als Quelle erscheinst, ist die Erwähnungsrate bei ChatGPT der falsche Trostwert.
- ChatGPT nennt Marken im Text und zitiert etwas anderes. Das ist die Erwähnung-versus-Zitat-Falle.
- Gemini und Google AI Overviews hängen näher am Google-Index. Nicht indexiert schmerzt hier zuerst.
- Derselbe Prompt, dieselbe Woche: in einer Plattform zitiert, in der anderen nicht. Das ist kein Rauschen. Deshalb optimiere ich nicht auf einen gemischten Score.
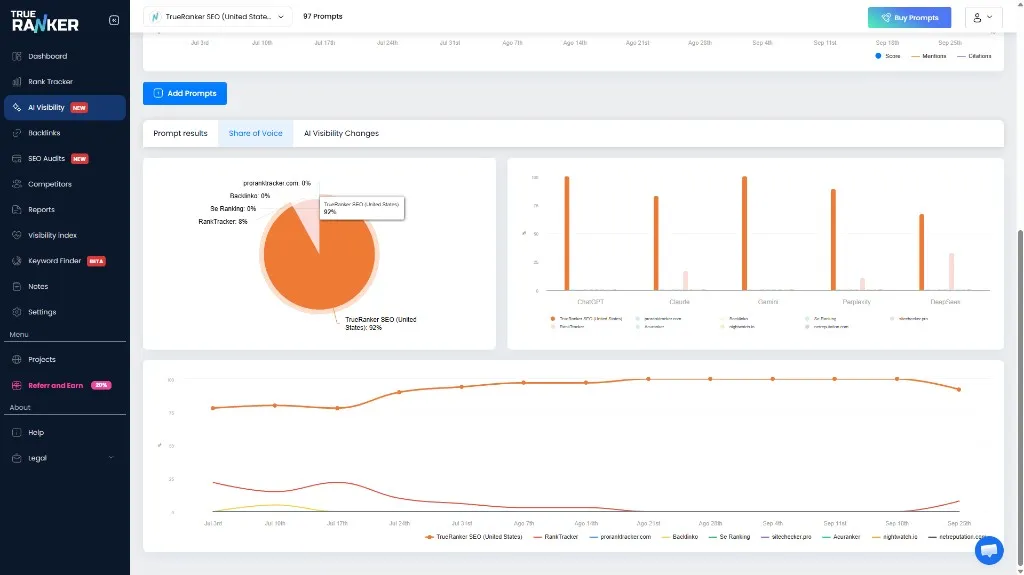
Share of Voice ist nicht in jeder Plattform gleich.
Wenn du nur ChatGPT testest, rätst du beim Rest.
Diese Ranking-Faktoren würde ich zuerst anpacken
Zuerst das, was dich aus dem abgerufenen Satz hält. Dann das, was eine Erwähnung in ein Zitat verwandelt. Mit Schema würde ich nicht anfangen.
Reihenfolge für diese Woche:
- Kann die URL abgerufen werden? Indexiert, 200, kein Canonical, der dich weglegt.
- Beantwortet der erste Bildschirm den Prompt? Query-Match vor Markentext.
- Scheitert es an Erwähnung oder fehlender URL? Nicht die ganze Site umschreiben wegen eines Namensproblems.
- Lässt sich ein Abschnitt übernehmen? Antwort, Liste, Hinweis.
- Ist der Prompt datiert? Shortlist aktualisieren, wenn ja; Glossar in Ruhe lassen, wenn nein.
- Ist die Entität inkonsistent? Name und Job im Cluster angleichen.
- Welche Drittseiten zitiert dieser Prompt schon? Dort rein – oder die Seite schreiben, die das Modell lieber zitiert als ein Round-up.
Schema-Markup ist nett für Parser. Allein dreht es einen Prompt von „nennt Wettbewerber“ nicht auf „zitiert unsere URL“.
2026 reicht ein Top-10-Ranking bei Google nicht mehr für KI-Zitate
Die Annahme, dass ein Top-10-Ranking bei Google noch ein KI-Zitat vorhersagt, trifft schlechter zu als früher – und war nie eine Garantie.
Ich will, dass die Seite rankt. Crawlbarkeit, echte Antwort, eine Website, die andere schon zitieren: das ist die Basis. Der Fehler ist, Platz drei mit „ChatGPT hat diese URL genutzt“ gleichzusetzen.
Etwa 400 kommerzielle Anfragen in dem Rankings-versus-KI-Sichtbarkeits-Post: Die Google-Position war ein schwacher Indikator dafür, ob das Modell die Marke nannte. Ich kopiere keine 2026-Prozentzahl aus einem Round-up, das ich nicht zitieren kann.
Praktisch ändert sich die Arbeitseinheit. Du exportierst keine Keywords in ein KI-Dashboard und nennst es GEO. Du verfolgst dieselben Business-Prompts und schaust, ob die zitierte URL deine ist.
So erkennst du, welcher Faktor an einem Prompt gewechselt hat
Du legst einen Prompt fest, startest ihn in mehr als einer Plattform und bewertest Erwähnung und zitierte URL getrennt. Ein siteweiter „KI-Score“ kann das nicht.
Das ist die Prüfung, die in Checklisten oft außer Acht gelassen wird. Die geben der Domain eine Note. Ich bewerte eine Frage.
Wähle einen Prompt, den ein Kunde wirklich tippt – „bester Rank-Tracker für Agenturen“, nicht dein Markenname. Starte ihn in ChatGPT, Perplexity, Gemini und im Google AI Overview, wenn es erscheint.
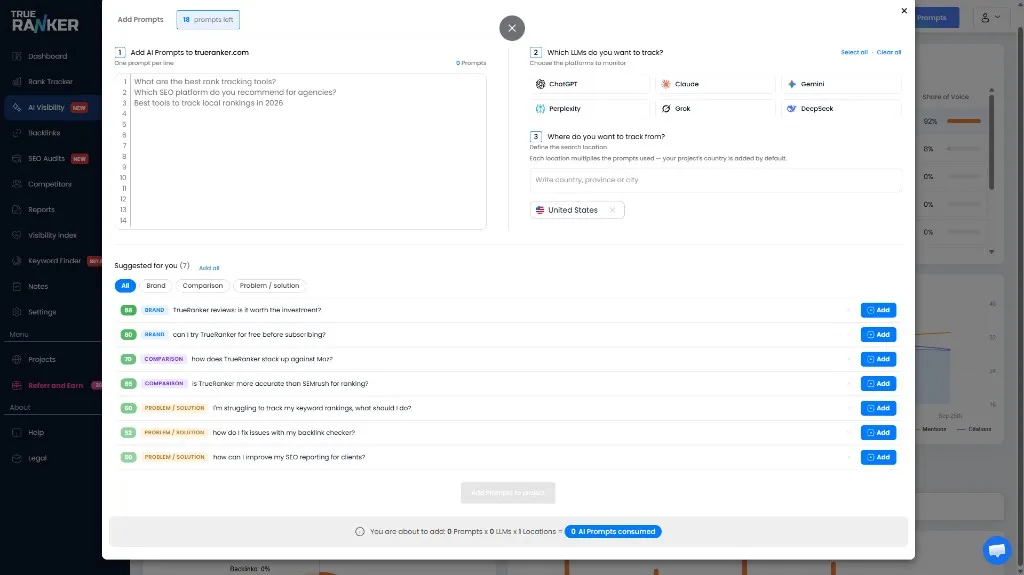
Derselbe Prompt, die Plattformen, die zählen, ein Standort.
Pro Plattform zwei Markierungen:
- Erwähnung: steht dein Name im Text?
- Zitat: steht deine URL in den Quellen?
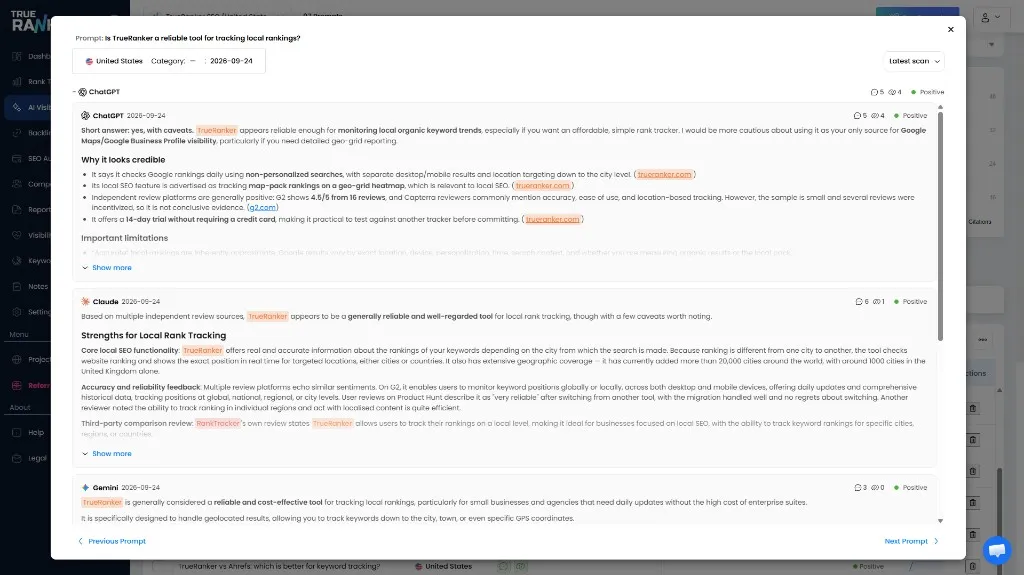
Öffne die gespeicherte Antwort. Markiere den Markennamen, dann suche deine URL.
Dann ordnest du den Fehler zu:
- Keine Erwähnung, kein Zitat,
site:liefert die URL nicht → Erreichbarkeit. - Keine Erwähnung, Seite existiert, erster Bildschirm antwortet nicht → Query-Match.
- Im Satz genannt, Round-up in den Quellen → Zitat versus Erwähnung, oft plus Drittquellen.
- Letzten Monat zitiert, diesen Monat weg, Prompt enthält ein Jahr → Freshness.
- In Perplexity zitiert, in ChatGPT unsichtbar → Plattform-Unterschied, kein fehlerhaftes Core Web Vital.
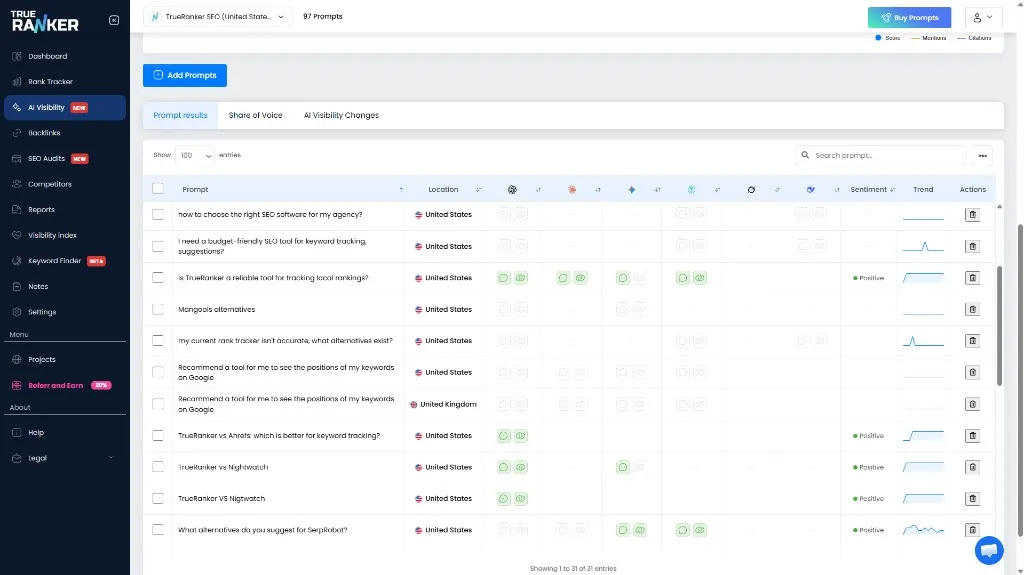
Erwähnung versus Zitat, Plattform für Plattform, auf denselben Prompts.
Willst du die Prüfung im Rhythmus statt in einem Tab, den du vergisst: verfolge diesen Prompt in ChatGPT. Erwähnungen und Zitate stehen in getrennten Spalten. Die Sechs-Plattformen-Ansicht liegt im AI Visibility Tracker.
Häufige Fragen
Was sind Ranking-Faktoren in der KI-Suche?
Das ist alles, was wahr sein muss, bevor ChatGPT, Perplexity, Gemini oder ein Google AI Overview deine Seite als Quelle nutzt. Das sind nicht die veröffentlichten Google-Ranking-Systeme in einer neuen Tabelle.
Brauchst du Platz eins bei Google, um zitiert zu werden?
Nein. Overviews und Chat-Antworten ziehen oft Seiten, die nicht in den Top drei stehen. Du brauchst trotzdem Erreichbarkeit. Ranking hilft. Es garantiert kein Zitat.
Unterscheiden sich Ranking-Faktoren je Plattform?
Ja. Perplexity zitiert mehr. ChatGPT erwähnt dich und zitiert jemand anderen. Gemini und AI Overviews hängen näher am Google-Index. Starte denselben Prompt in mehr als einer Plattform, bevor du entscheidest, was du optimierst.
Entscheidet Schema-Markup über ein Zitat?
Schema kann eine Seite leichter parsbar machen. Allein entscheidet es kein Zitat. Direkte Antworten, erreichbare URL und Präsenz in den Quellen, die das Modell ohnehin liest, zählen mehr.
Wie erkenne ich, welcher Faktor wirklich gewechselt hat?
Starte einen Prompt erneut und bewerte Erwähnung versus zitierte URL, Plattform für Plattform, nach der Änderung. Erscheint die Erwähnung und die URL bleibt weg, hast du den Zitat-Faktor nicht behoben. Ein gemischter Sichtbarkeits-Score versteckt das.
Sieh, welche Plattformen dich zitieren – und welche dich nur nennen.
Verfolge denselben Prompt in ChatGPT und den anderen Modellen. Erwähnungen und Zitate stehen in getrennten Spalten, damit du den Faktor erkennst, der wirklich gewechselt hat.
Geschrieben von
Javier Quevedo
Mitgründer & CEO, SEO Lead
Javier hat TrueRanker mitgegründet und führt Frontend, öffentliche Website und die letzte Meile zwischen einem Ranking in der Datenbank und dem Screen, den ein SEO wirklich nutzt. Seit Jahren macht er aus GEO, Local SEO, On-Page und KI-Sichtbarkeit Produkt — und die Guides in diesem Blog — damit Agenturen ChatGPT-Zitationen so messen wie Google. Er arbeitet auch am Backend: eine saubere Oberfläche über alten Daten ist reine Augenwischerei.
Das könnte Sie interessieren
Die Checkliste zur KI-Suchoptimierung, die ich durchgehe, bevor ich eine Seite ändere.
Mit der Checkliste zur KI-Suchoptimierung nimmst du einen Prompt, prüfst Zitat oder Erwähnung und schaust, ob die Seitenänderung etwas gebracht hat.
Javier Quevedo10 Min. Lesezeit
Beitrag lesen