Como encontrar e escolher os prompts certos para a sua visibilidade em IA
Como escolher prompts para visibilidade em IA: da simulação de compradores a 100 testes. Descubra quais perguntas geram citações reais no ChatGPT.

Conhece bem esta frustração: abre o ChatGPT, pergunta qual é o melhor software do seu setor e vê o modelo recomendar três dos seus concorrentes diretos, ignorando completamente a sua marca. Repete a mesma pergunta um minuto depois e a resposta muda. Volta a testar no dia seguinte e as fontes citadas são novamente diferentes.
Se abordar a monitorização de prompts em IA da mesma forma que o acompanhamento clássico de palavras-chave, vai perder semanas a acumular dados sem utilidade. Os grandes modelos de linguagem não operam com volumes de pesquisa mensais fixos nem devolvem uma lista estática de dez links azuis. São sistemas probabilísticos que sintetizam cada resposta em tempo real a partir de pesquisas na web em direto, consultas vetoriais e do seu próprio raciocínio interno.
Para construir uma estratégia de visibilidade em IA que realmente tenha impacto nas métricas do seu negócio, precisa de descobrir as perguntas conversacionais exatas que os seus compradores reais colocam, validar a sua consistência estatística e identificar quais os prompts que geram citações diretas para o seu domínio. Apresentamos aqui a metodologia em cinco passos que utilizamos para encontrar, validar e monitorizar os prompts certos na pesquisa com IA.
Porque a monitorização de prompts não é uma pesquisa de palavras-chave disfarçada
Monitorizar prompts é um processo profundamente distinto da pesquisa tradicional de palavras-chave, uma vez que as pesquisas conversacionais ativam uma decomposição em múltiplas subconsultas e uma síntese probabilística em tempo real, em vez de compararem uma expressão contra um índice estático. O motor de IA avalia as nuances da pergunta do utilizador, pesquisa fontes na web em direto, analisa os fragmentos recolhidos e redige uma resposta inédita a cada execução.
Quando alguém escreve melhor rank tracker no Google, o motor compara a palavra-chave com o seu índice invertido. Praticamente todos os utilizadores na mesma localização geográfica veem resultados quase idênticos. No entanto, quando um potencial comprador pede recomendações ao ChatGPT ou ao Perplexity, o assistente interpreta as suas restrições operacionais, consulta fontes de referência na web e elabora uma análise comparativa personalizada.
Três diferenças essenciais distinguem o estudo de prompts da SEO convencional:
- Ausência de volume de pesquisa mensal fixo: As ferramentas tradicionais indicam que uma palavra-chave tem 2.400 pesquisas por mês. Os prompts não têm essa métrica porque as conversas humanas admitem infinitas variações semânticas. Monitorizam-se grupos de intenções e necessidades reais, não cadeias exatas de texto.
- Contextualização e divisão de consultas (query fan-out): Um prompt como «Que alternativas sugere ao SerpRobot para uma agência que gere 50 clientes locais?» obriga o modelo a executar múltiplas pesquisas em simultâneo (comparação de tabelas de preços, suporte para várias localizações ou emissão de relatórios para clientes).
- Deriva probabilística das citações: Na pesquisa clássica, um URL em terceira posição tende a manter-se estável durante dias ou semanas. Nos modelos de linguagem, uma marca mencionada no primeiro teste pode desaparecer no terceiro se a consulta não tiver sido validada estatisticamente ao longo de várias execuções.
| Critério de avaliação | Monitorização clássica de palavras-chave | Monitorização de prompts para LLMs |
|---|---|---|
| Volume de pesquisa | Estimativas mensais fixas (Ahrefs, GSC) | Sem volume fixo; clusters de intenções conversacionais |
| Formato de saída | Lista ordenada de links azuis (1 a 10) | Texto sintetizado, pontos comparativos e links de citação |
| Estabilidade | Posições diárias relativamente estáveis | Probabilística; respostas e fontes variam por execução |
| Ativo de conversão | Posicionamento orgânico na primeira página | Menção em destaque e link de citação para o site |
| Mecanismo de pesquisa | Consulta única sobre um índice invertido | Decomposição em subconsultas, extração web e síntese |
| Objetivo principal | Conquistar cliques orgânicos a partir das SERPs | Obter recomendações de marca e citações de domínio |
Passo 1: Defina o contexto operacional do seu projeto e o perfil dos seus clientes
Antes de pedir ideias de prompts a um modelo de linguagem, deve fornecer-lhe um enquadramento operacional rigoroso com o perfil do seu comprador ideal, a sua oferta principal, as objeções habituais e o vocabulário real dos seus clientes. Se fizer perguntas a uma IA sem este contexto prévio, receberá apenas listas genéricas de questões que nenhum comprador real formularia.
Nas auditorias que realizo com fundadores e equipas de marketing, começo sempre por analisar as gravações de reuniões comerciais, os tickets de suporte e as notas do CRM. Os clientes reais raramente fazem perguntas enciclopédicas como «O que é um software de SEO?». Apresentam dúvidas concretas decorrentes dos seus problemas diários:
- Setor e dimensão da equipa: Um consultor independente pesquisa de forma diferente do responsável de uma agência com 20 especialistas.
- Fricções e pontos de estrangulamento: Custos por utilizador excessivos, aumentos abruptos de preço na mudança de plano, ausência de seguimento no Google Maps ou atualizações de posições demasiado lentas.
- Objeções comerciais frequentes: «Porque deveria pagar por isto se já tenho o Google Search Console?» ou «Como posso exportar facilmente estes dados para os meus relatórios mensais?».
- Requisitos indispensáveis: Relatórios white-label para clientes, precisão local ao nível do código postal ou monitorização multi-modelo em IA.
Introduza este contexto na sua sessão de trabalho antes de avançar para as simulações. Quando o modelo compreende os limites práticos do seu negócio, as perguntas geradas reproduzem com rigor os diálogos reais de um processo de contratação.
Passo 2: Aplique engenharia inversa à intenção de compra através de simulações
A engenharia inversa da intenção de compra consiste em solicitar a modelos com elevada capacidade de raciocínio que assumam o papel do seu cliente ideal, simulando as suas dúvidas ao longo de todo o ciclo de decisão. Em vez de tentar adivinhar o que um utilizador digitaria, leva o modelo a percorrer o seu raciocínio: desde a identificação do problema inicial até ao confronto final entre fornecedores.
Para esta etapa utilizo modelos dotados de capacidades de raciocínio profundo (como OpenAI o3, Claude 3.7 Sonnet ou Gemini 2.0 Pro) com uma instrução de simulação detalhada:
«Assume o papel do responsável de SEO de uma agência especializada que faz a gestão de 30 clientes locais. Estás cansado de ferramentas com licenças por utilizador abusivas e de plataformas ultrapassadas que não acompanham a pesquisa com IA. Escreve 15 perguntas concretas e conversacionais que colocarias ao ChatGPT ou ao Perplexity para encontrar, comparar e justificar a mudança para uma ferramenta mais moderna.»
Esta simulação dá origem a prompts organizados em três fases comerciais muito claras:
Prompts focados em sintomas e pontos de dor
Os prompts de pontos de dor captam o utilizador no momento em que enfrenta um problema técnico ou uma quebra de tráfego e recorre a um assistente de IA para perceber o motivo.
Geralmente começam por expor a dificuldade de forma direta:
- «Porque é que o Google Search Console não mostra as mesmas posições de palavras-chave que as ferramentas externas de rank tracking?»
- «Porque é que o tráfego orgânico do meu site está a cair se as posições no Google permanecem estáveis?»
- «Como posso saber se o ChatGPT está a citar os meus concorrentes em vez do meu domínio?»
Conseguir uma citação nestas respostas posiciona a sua empresa como uma referência técnica antes mesmo de o comprador começar a avaliar marcas concretas.
Prompts comerciais e comparativos entre concorrentes
Os prompts comerciais e comparativos surgem quando o potencial cliente está a analisar alternativas no mercado e pede ao modelo que compare ferramentas específicas.
Estas perguntas concentram as oportunidades com maior potencial de conversão:
- «Qual é o melhor software de SEO para pequenas agências em 2026?»
- «Que alternativas recomenda ao SerpRobot?»
- «Wincher vs ProRankTracker vs TrueRanker: qual funciona melhor para monitorização local?»
Apresentamos um caso real retirado do nosso painel que demonstra por que razão as consultas comparativas superam largamente as pesquisas genéricas de categoria.
Na semana passada, ao analisar os dados de monitorização ativos nos Estados Unidos, no Reino Unido e na Índia, registei um contraste muito evidente entre dois tipos de pesquisas:
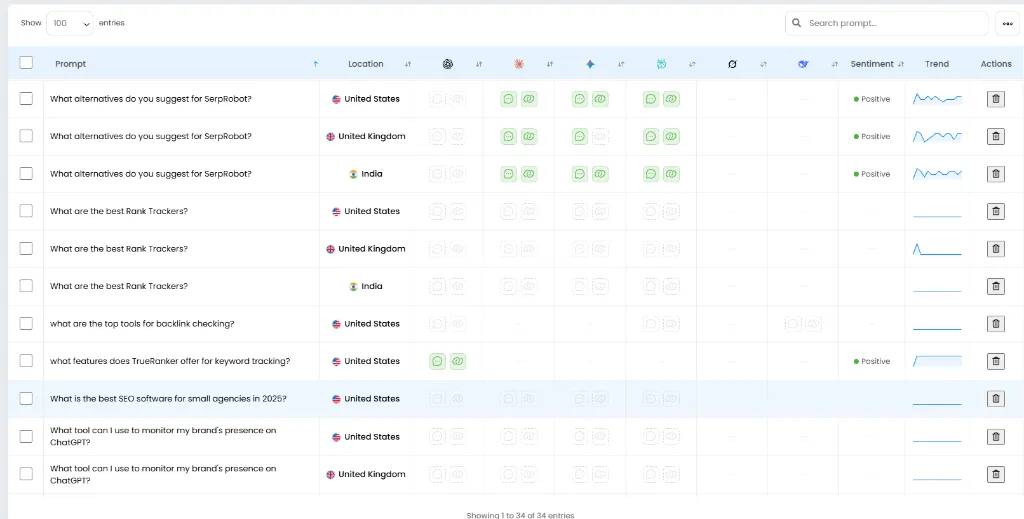
Em prompts de categoria ampla como «What are the best Rank Trackers?», a visibilidade quase não variava entre os modelos. A explicação? As consultas genéricas devolvem resumos baseados em artigos de afiliados com vários anos de existência online.
Em contrapartida, no prompt de substituição de concorrentes no topo da lista («What alternatives do you suggest for SerpRobot?»), o cenário era totalmente diferente: o sentimento era fortemente positivo e surgiam citações confirmadas a verde no Claude, Gemini e Copilot.
Ao analisar o detalhe da consulta no ChatGPT para essa pesquisa no Reino Unido, o resultado foi conclusivo:
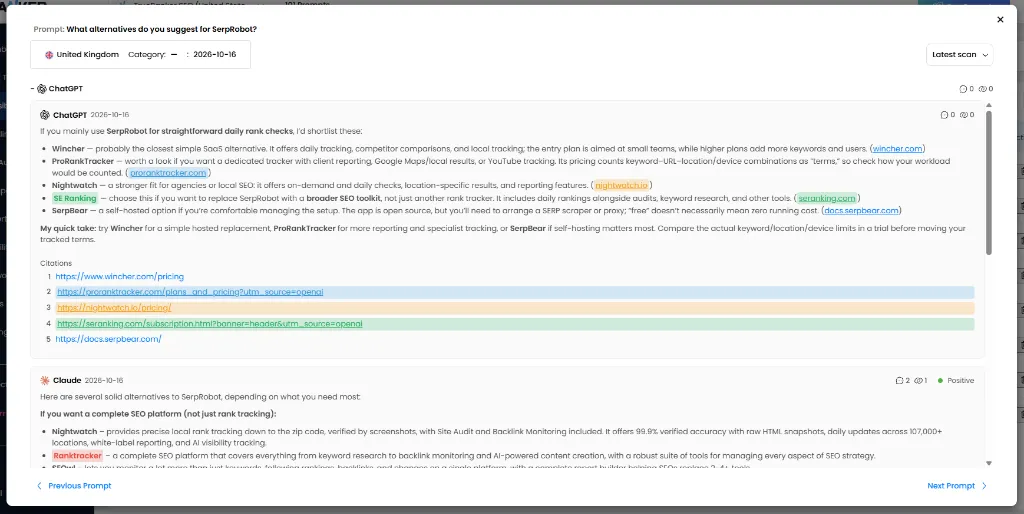
O ChatGPT não se limitou a mencionar marcas no corpo do texto; o seu motor de pesquisa web incorporou citações diretas para páginas de planos e preços. Repare nos links apresentados no final da resposta:
https://www.wincher.com/pricinghttps://proranktracker.com/plans_and_pricing?utm_source=openaihttps://nightwatch.io/pricing/https://seranking.com/subscription.html?banner=header&utm_source=openaihttps://docs.serpbear.com/
Duas destas citações incluem parâmetros de tracking explícitos utm_source=openai. Isto comprova que o rastreador da OpenAI analisou essas páginas de tarifas, compreendeu as suas condições e exibiu links diretos e clicáveis a um utilizador que procurava ativamente substituir o seu fornecedor atual.
Se apenas monitorizar expressões genéricas, perderá o momento exato em que são tomadas as decisões de compra na pesquisa conversacional.
Consultas com fator de proximidade e transações locais
As pesquisas transacionais associadas à proximidade geográfica respondem a decisões imediatas em que a localização ou a cobertura local determina a recomendação do assistente.
Costumam integrar especificações territoriais:
- «Quais são as agências de SEO técnico mais bem avaliadas no Porto para lojas online?»
- «Qual é a melhor ferramenta para monitorizar diariamente as posições no Google Local Pack para várias cidades em simultâneo?»
Os assistentes de IA consultam bases de dados geográficas e fontes web locais para responder a estas solicitações. Para as monitorizar com rigor, deve segmentar os seus testes por país e por cidade para identificar variações regionais nas citações.
Passo 3: Analise as fontes de extração dos motores de IA com acesso à web
Analisar as fontes de extração consiste em testar os seus prompts candidatos em motores de IA conectados à internet, de modo a identificar que publicações, fóruns e diretórios alimentam as suas citações. Os modelos não inventam as soluções que recomendam; recolhem informações em tempo real junto de um grupo restrito de referências antes de estruturarem a resposta.
Quando ferramentas como o Perplexity, o SearchGPT ou o Gemini respondem a uma questão, exibem notas de rodapé ou botões interativos com as suas referências. Fazer o registo dessas fontes revela-lhe o mapa exato de visibilidade dessa pesquisa:
- Teste os prompts candidatos em motores conectados: Passe a sua lista inicial de 30 consultas pelo Perplexity, ChatGPT Search e pelas AI Overviews da Google.
- Registe os domínios citados de forma recorrente: Verifique se o assistente fundamenta a resposta em avaliações independentes, discussões no Reddit, documentação técnica ou artigos comparativos de blogs do setor.
- Identifique padrões de indexação: Se em quatro de cada cinco testes o modelo citar artigos de análise técnica ou páginas de destino de produtos, o seu site necessita de páginas com profundidade equivalente ou de estar presente nessas fontes de referência.
- Descarte prompts que não acionem pesquisa web: Se uma pergunta apenas extrai conhecimento da memória interna do modelo sem efetuar buscas externas, será impossível avaliar citações de URL. Concentre-se nos prompts que desencadeiam pesquisas na web de forma sistemática.
Compreender este mecanismo de recolha é indispensável para gerir a sua visibilidade em IA, onde a relevância e autoridade das fontes consultadas determinam que marcas recebem links visíveis.
Passo 4: Valide a consistência de cada prompt através de testes estatísticos
A validação estatística confirma se um prompt garante visibilidade consistente para a sua marca ao executar a mesma pergunta entre 60 e 100 vezes, calculando assim a probabilidade real de citação. Dado que os modelos generativos operam de forma probabilística, testar um prompt apenas uma ou duas vezes não oferece qualquer segurança analítica.
Nas nossas análises internas, um prompt sem validação pode recomendar uma marca numa terça-feira de manhã e ignorá-la por completo na quarta-feira à tarde. Esta oscilação decorre da temperatura do modelo, de variações na semente (seed) e das atualizações contínuas dos índices de pesquisa web.
Limiares de fiabilidade estatística de um prompt:
  1 teste manual:      ~10% a 20% de fiabilidade (Sem valor analítico)
  10 testes:           ~50% de fiabilidade (Variância elevada)
  60 a 100 testes:     >95% de fiabilidade (Linha de base comercial fiável)
Nesta fase de verificação deve diferenciar claramente duas métricas complementares:
- Taxa de menção da marca (Brand Mention Rate): A percentagem de execuções em que o modelo refere o nome da sua empresa ou produto no corpo do texto gerado.
- Taxa de citação do domínio (Domain Citation Rate): A percentagem de execuções em que o motor insere um link clicável para o seu site entre as fontes de referência.
Uma menção da marca gera notoriedade passiva, mas apenas uma citação de domínio encaminha tráfego qualificado diretamente para o seu funil de vendas. Se após 80 execuções um prompt registar 40% de menções mas 0% de citações, significa que o modelo reconhece a sua entidade, mas não encontra nenhum URL estruturado com a clareza necessária para servir de fonte de dados.
Pretende automatizar estes testes sem perder horas de trabalho? Verificar 100 perguntas manualmente em cinco plataformas de IA consome imenso tempo e esgota rapidamente os créditos de API. Pode acompanhar a sua visibilidade conversacional e taxas de citação de forma automatizada com a nossa solução de visibilidade em IA, obtendo métricas probabilísticas precisas sem necessidade de desenvolver scripts próprios.
Passo 5: Agrupe por clusters semânticos e estruture o seu conteúdo para extração por IA
Agrupar os seus prompts validados em vertentes informativas e transacionais permite-lhe otimizar a estrutura das suas páginas com blocos de resposta direta, facilitando a extração e citação do seu conteúdo pelos motores de IA. Após depurar a sua lista de consultas, organize-as em conjuntos coerentes que orientem o seu plano editorial.
Dividimos habitualmente os prompts em duas grandes vertentes operacionais:
- Vertentes informativas: Dúvidas sobre conceitos, comparações de arquitetura técnica, resolução de problemas e guias metodológicos. Encontram o seu espaço ideal em artigos de blog ou em centros de documentação.
- Vertentes transacionais: Pedidos de preços, processos de migração entre ferramentas, comparação de funcionalidades e alternativas comerciais. Devem ser abordadas em páginas de produto e landing pages comparativas dedicadas.
Para que os sistemas de extração consigam citar os seus textos com facilidade (otimização por fragmentos ou chunking), inclua uma resposta direta e completa de 1 a 2 frases imediatamente abaixo de cada cabeçalho H2 e H3. Evite introduções prolixas ou rodeios retóricos. Quando o rastreador de um modelo de linguagem segmenta a página em blocos semânticos, essa primeira resposta fornece exatamente a declaração autónoma de que necessita para fundamentar a resposta.
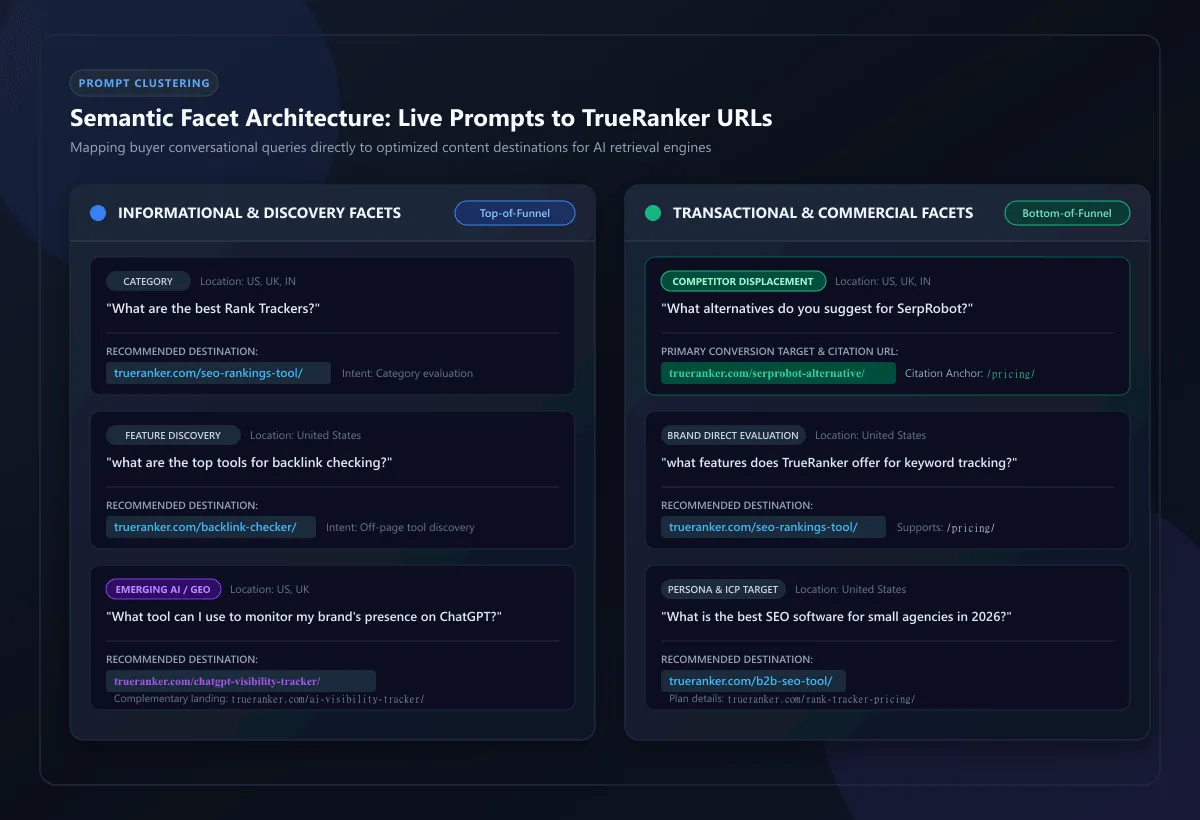
A tabela seguinte ilustra a forma como associamos cada prompt extraído das nossas análises à sua respetiva vertente, intenção de compra e URL de destino recomendado dentro do TrueRanker:
| Prompt analisado | Vertente semântica | Intenção de compra | URL recomendado no TrueRanker | Cabeçalho para extração direta (Chunk) |
|---|---|---|---|---|
| «What alternatives do you suggest for SerpRobot?» | Transacional | Substituição de concorrente (Fundo de funil) | /pt/alternativa-a-serprobot/ & /pt/precos/ |
Porque o TrueRanker é a alternativa mais direta ao SerpRobot |
| «What are the best Rank Trackers?» | Informativa / Categoria | Avaliação global do mercado (Topo de funil) | /pt/monitorizacao-de-posicoes/ |
Que funcionalidades definem um rank tracker moderno em 2026 |
| «what are the top tools for backlink checking?» | Informativa / Descoberta | Avaliação de funcionalidade complementar | /pt/monitor-backlinks/ |
Monitorização de backlinks em tempo real sem custos enterprise |
| «what features does TrueRanker offer for keyword tracking?» | Transacional | Avaliação direta da marca e ferramentas | /pt/monitorizacao-de-posicoes/ |
Principais funcionalidades de monitorização de palavras-chave no TrueRanker |
| «What is the best SEO software for small agencies in 2026?» | Transacional / Perfil de agência | Decisão de compra B2B para agências e equipas | /pt/ferramenta-seo-agencias/ |
Porque as agências escolhem o TrueRanker face a ferramentas com licenças por utilizador |
| «What tool can I use to monitor my brand’s presence on ChatGPT?» | Emergente IA / GEO | Monitorização de presença e reputação de marca em IA | /pt/visibilidade-chatgpt/ |
Como monitorizar menções e citações da sua marca no ChatGPT |
Como automatizar a monitorização de prompts sem scripts manuais
Automatizar a monitorização de prompts através de uma plataforma especializada elimina a complexidade técnica associada à gestão de chamadas de API e à manutenção de scrapers com browsers headless. Acompanhar manualmente dezenas de perguntas no ChatGPT, Claude, Gemini e Perplexity é inviável para uma agência ou empresa em crescimento.
Desenvolver uma infraestrutura interna obriga à gestão de proxies residenciais rotativos, ao processamento de respostas em markdown sem formato estruturado, ao controlo de limites de pedidos e a encargos de tokens que disparam rapidamente ao efetuar 100 testes por prompt. Além disso, as APIs para programadores raramente reproduzem o comportamento exato dos motores de pesquisa orientados ao consumidor, como o ChatGPT Search.
Foi por essa razão que integrámos a monitorização de visibilidade no ChatGPT no TrueRanker. Em vez de depender de folhas de cálculo manuais, a plataforma assegura todo o fluxo:
- Sugestões inteligentes de prompts: Descoberta de perguntas conversacionais relevantes para o seu mercado com base em padrões de pesquisa reais.
- Monitorização contínua multi-modelo: Rastreios programados no ChatGPT, Claude, Gemini, Copilot e Perplexity com segmentação por país.
- Análise de sentimento e citações: Deteção da tonalidade (positiva, neutra ou negativa) e alertas sempre que um concorrente conquista uma citação no seu lugar.
- Cálculo da Share of Voice: Medição exata da percentagem de respostas no seu setor em que a sua marca é recomendada face aos rivais diretos.
Pode consultar os nossos limites de monitorização e planos disponíveis na nossa página de preços, adaptáveis às suas necessidades sem contratos de permanência obrigatórios.
Perguntas frequentes
Com quantos prompts se deve iniciar a monitorização?
É aconselhável começar com um grupo de 20 a 40 prompts, distribuídos de forma equilibrada entre comparações comerciais e perguntas focadas na resolução de problemas. Este volume inicial previne a dispersão de orçamento e permite consolidar uma linha de base segura de citações antes de expandir a lista.
Faz sentido acompanhar prompts se cada utilizador pesquisa de forma diferente no ChatGPT?
Sim, porque os modelos de linguagem associam milhares de formulações distintas aos mesmos conceitos semânticos e às mesmas tarefas de recuperação. Não precisa de monitorizar cada variação frásica; acompanhar o prompt central permite-lhe avaliar com rigor a forma como o modelo processa toda essa intenção de pesquisa.
Qual é a diferença entre uma menção de marca e uma citação nos motores de IA?
Uma menção de marca ocorre quando o motor escreve o nome do seu produto no corpo do texto, ao passo que uma citação inclui um link ativo e clicável para o seu domínio entre as fontes de referência. São as citações que geram tráfego qualificado e confirmam que o modelo utilizou a sua página para fundamentar a resposta.
Com que frequência deve ser revista a lista de prompts?
Recomenda-se auditar a seleção de prompts a cada 30 a 60 dias, permitindo retirar as perguntas que já não acionem pesquisas na web e adicionar novas questões identificadas pela equipa comercial junto dos clientes. À medida que os motores de IA renovam os seus índices e os concorrentes lançam novos conteúdos, as pesquisas dos utilizadores evoluem de forma natural.
Descubra o que os motores de IA dizem sobre a sua marca
O TrueRanker identifica as perguntas reais dos seus compradores e monitoriza as suas menções e citações no ChatGPT, Perplexity, Claude e Gemini automaticamente.
Escrito por
Javier Quevedo
Cofundador e CEO, Lead SEO
O Javier cofundou a TrueRanker e lidera o frontend, o site público e o último troço entre um ranking na base de dados e o ecrã que um SEO usa de verdade. Há anos que transforma GEO, SEO local, on-page e visibilidade em IA em produto — e nas guias deste blog — para as agências medirem citações no ChatGPT como já medem o Google. Também trabalha o backend: uma interface limpa sobre dados velhos continua a ser uma mentira.
Pode interessar-te
Porque o seu ranking no Google não diz nada sobre a sua visibilidade em IA
Ser o #3 no Google não o coloca na resposta do ChatGPT. Porque as duas coisas se separaram e o que medir em vez disso.
TrueRanker2 min de leitura
Ler o artigo