Wie du die richtigen Prompts für deine KI-Sichtbarkeit auswählst
So wählst du Prompts für KI-Sichtbarkeit aus: Von Buyer-Simulationen bis zu 100 Testläufen. Finde heraus, welche Prompts echte Zitate in ChatGPT bringen.

Das kennst du sicher: Du öffnest ChatGPT, fragst nach der besten Software in deiner Branche und siehst, wie das Modell drei deiner Wettbewerber empfiehlt – während deine eigene Marke mit keinem Wort erwähnt wird. Du schickst dieselbe Frage eine Minute später erneut ab, und die Antwort verändert sich. Du testest es am nächsten Tag, und die genannten Quellen sind wieder andere.
Wenn du Prompt-Tracking in der KI-Suche wie klassisches Keyword-Monitoring behandelst, sammelst du wochenlang nutzlose Daten. Große Sprachmodelle arbeiten weder mit festen monatlichen Suchvolumina noch liefern sie deterministische Ranking-Listen. Sie sind probabilistische Systeme, die jede Antwort in Echtzeit aus Live-Websuchen, semantischen Vektorabfragen und eigenem logischen Schließen synthetisieren.
Um eine Strategie für KI-Sichtbarkeit aufzubauen, die echte Geschäftszahlen bewegt, musst du die konkreten Konversationsfragen deiner echten Käufer aufdecken, ihre statistische Beständigkeit prüfen und herausfinden, welche Prompts verlässliche Zitate auf deine Domain auslösen. Hier ist der fünfstufige Leitfaden, den wir nutzen, um die richtigen Prompts für KI-Sichtbarkeit zu finden, zu validieren und kontinuierlich zu überwachen.
Warum Prompt-Tracking keine getarnte Keyword-Recherche ist
Prompt-Tracking unterscheidet sich grundlegend von der klassischen Keyword-Recherche, weil Konversationsabfragen eine mehrstufige Zerlegung und probabilistische Synthese in Echtzeit auslösen, statt gegen einen statischen Index abzugleichen. Das KI-Modell analysiert die feinen Nuancen der Nutzerfrage, sucht im Live-Web nach relevanten Informationen, bewertet die gefundenen Textpassagen und formuliert für jeden Durchlauf eine komplett eigenständige Antwort.
Wenn jemand bestes rank tracking tool bei Google eingibt, gleicht die Suchmaschine den Begriff mit einem invertierten Index ab. Nahezu alle Suchenden am selben Standort sehen identische Trefferlisten. Wenn ein Kaufinteressent dagegen ChatGPT oder Perplexity nach einer Software-Empfehlung fragt, interpretiert der Assistent dessen spezifische Anforderungen, konsultiert externe Referenzquellen und stellt einen individuellen Vergleich zusammen.
Drei wesentliche Unterschiede trennen die Recherche von KI-Prompts von der traditionellen SEO-Arbeit:
- Kein statisches monatliches Suchvolumen: Klassische SEO-Tools zeigen dir, dass ein Keyword 2.400 monatliche Suchanfragen hat. Prompts besitzen diese Kennzahl nicht, weil menschliche Dialoge unendliche semantische Variationen zulassen. Du überwachst Absichts-Cluster und Informationsbedarfe, keine starren Textketten.
- Kontextuelle Tiefe und Abfragezerlegung (Query Fan-out): Ein Prompt wie „Welche Alternativen zu SerpRobot empfiehlst du für eine Agentur mit 50 lokalen Kunden?“ zwingt das Modell dazu, im Hintergrund mehrere Teilabfragen parallel zu starten (Preise vergleichen, Multi-Standort-Tauglichkeit prüfen oder Kunden-Reporting analysieren).
- Probabilistische Drift bei Zitaten: In der organischen Google-Suche bleibt eine URL auf Position drei meist über Tage hinweg stabil. In Sprachmodellen kann eine Marke im ersten Durchlauf prominent empfohlen werden und im dritten komplett verschwinden, wenn der Prompt nicht über viele Testläufe hinweg statistisch abgesichert wurde.
| Bewertungsmetrik | Klassisches Keyword-Tracking | Prompt-Tracking in LLMs |
|---|---|---|
| Suchvolumen | Feste monatliche Schätzungen (Ahrefs, GSC) | Kein fixes Volumen; Absichts-Cluster in Dialogform |
| Ausgabeformat | Geordnete Liste blauer Links (1 bis 10) | Synthetisierter Fließtext, Vergleichspunkte und Zitate |
| Stabilität | Relativ stabile tägliche Positionen | Probabilistisch; Antworten und Quellen variieren pro Test |
| Conversion-Hebel | Organische Platzierung auf Seite 1 | Markenerwähnung und anklickbarer Zitat-Link |
| Suchmechanik | Einfache Abfrage gegen einen invertierten Index | Mehrstufiges Query Fan-out, Retrieval und Web-Synthese |
| Hauptziel | Organische Klicks aus den SERPs maximieren | Markenempfehlungen und Zitate für die Domain gewinnen |
Schritt 1: Den operativen Projektkontext und das Buyer-Profil definieren
Bevor du eine KI nach Prompt-Ideen fragst, musst du ihr den operativen Rahmen deines Zielkunden, typische Einwände und reale Aussagen aus Vertriebsgesprächen vorgeben. Wenn du ein Sprachmodell ohne dieses Vorwissen befragst, erhältst du lediglich austauschbare Standardfragen, die echte Kunden in einer Kaufentscheidung niemals stellen würden.
In unseren Beratungsgesprächen mit Gründern und SEO-Teams starten wir grundsätzlich mit der Auswertung von CRM-Notizen, Support-Tickets und Transkripten aus Sales-Calls. Reale Interessenten stellen selten allgemeine Fragen wie „Was ist ein SEO-Tool?“. Sie äußern ganz konkrete Reibungspunkte aus ihrem Arbeitsalltag:
- Branche und Unternehmensgröße: Ein Einzelunternehmer sucht völlig anders als der Head of SEO einer Agentur mit 20 Mitarbeitern.
- Typische Engpässe: Plötzliche Preisaufschläge bei Nutzerlizenzen, fehlendes Tracking für Google Maps oder quälend langsame Aktualisierungen von Rankings.
- Häufige Einwände: „Warum sollte ich dafür zahlen, wenn ich schon die Google Search Console habe?“ oder „Wie binde ich diese Daten in meine monatlichen Kundenberichte ein?“.
- Kritische Funktionsanforderungen: Automatisierte White-Label-PDFs, PLZ-genaues lokales Monitoring oder die kombinierte Erfassung von Google-Rankings und KI-Sichtbarkeit.
Gib diesen Kontext zu Beginn in deine Arbeitssitzung mit dem Modell ein. Nur wenn die KI die Grenzen deines Geschäftsmodells versteht, spiegeln die erzeugten Anfragen echte Kaufgespräche wider.
Schritt 2: Kaufabsichten durch KI-Simulationen rekonstruieren
Um herauszufinden, was Interessenten wirklich fragen, lässt du moderne Reasoning-Modelle in die Rolle deines Zielkunden schlüpfen und deren Rechercheprozess simulieren. Statt mühsam zu raten, welche Prompts relevant sein könnten, instruierst du das Modell, die Gedankengänge vom ersten technischen Problem bis zum finalen Software-Vergleich nachzubilden.
Für diese Simulation nutze ich fortschrittliche Reasoning-Modelle (wie OpenAI o3, Claude 3.7 Sonnet oder Gemini 2.0 Pro) mit einem präzisen Rollen-Prompt:
„Handle als Head of SEO einer Boutique-Agentur mit 30 Kundenprojekten. Du bist genervt von unvorhersehbaren Lizenzkosten pro Mitarbeiter und veralteten Rank-Trackern, die keine KI-Suchen abbilden. Erstelle eine Liste von 15 konkreten, dialogorientierten Fragen, die du ChatGPT oder Perplexity stellen würdest, um ein modernes Tool zu finden, zu vergleichen und den Wechsel intern zu rechtfertigen.“
Eine solche Simulation liefert typischerweise Prompts aus drei kommerziellen Phasen:
Problem- und Symptom-Prompts
Diese Anfragen erfassen den Nutzer, wenn ein technisches Problem auftritt und er die KI zunächst um eine Ursachenanalyse bittet.
Typische Formulierungen beschreiben das Symptom direkt:
- „Warum zeigt die Google Search Console andere Keyword-Rankings an als externe Ranking-Tools?“
- „Warum bricht mein organischer Traffic ein, obwohl meine Google-Positionen stabil bleiben?“
- „Wie kann ich überprüfen, ob ChatGPT meine Wettbewerber anstelle meiner Website zitiert?“
Wenn du bei solchen Problemanfragen als Quelle zitiert wirst, baust du bereits technische Autorität auf, bevor der Interessent überhaupt eine Shortlist von Anbietern erstellt hat.
Kommerzielle Prompts und Wettbewerber-Vergleiche
Hier vergleicht der Interessent aktiv konkrete Tools miteinander, was die höchste Conversion-Wahrscheinlichkeit bietet.
Diese Fragen konzentrieren deine stärksten Hebel für Neukunden:
- „Welches ist das beste SEO-Tool für kleine Agenturen im Jahr 2026?“
- „Welche Alternativen empfiehlst du zu SerpRobot?“
- „Wincher vs. ProRankTracker vs. TrueRanker: Welches Tool eignet sich am besten für lokales Ranking-Monitoring?“
Lass mich das an einem realen Beispiel aus unserem Dashboard verdeutlichen, das belegt, warum Vergleichsanfragen herkömmliche Kategorie-Keywords bei weitem übertreffen.
Letzte Woche fiel mir bei der Durchsicht unserer Monitoring-Läufe in den USA, Großbritannien und Indien ein deutlicher Kontrast auf:
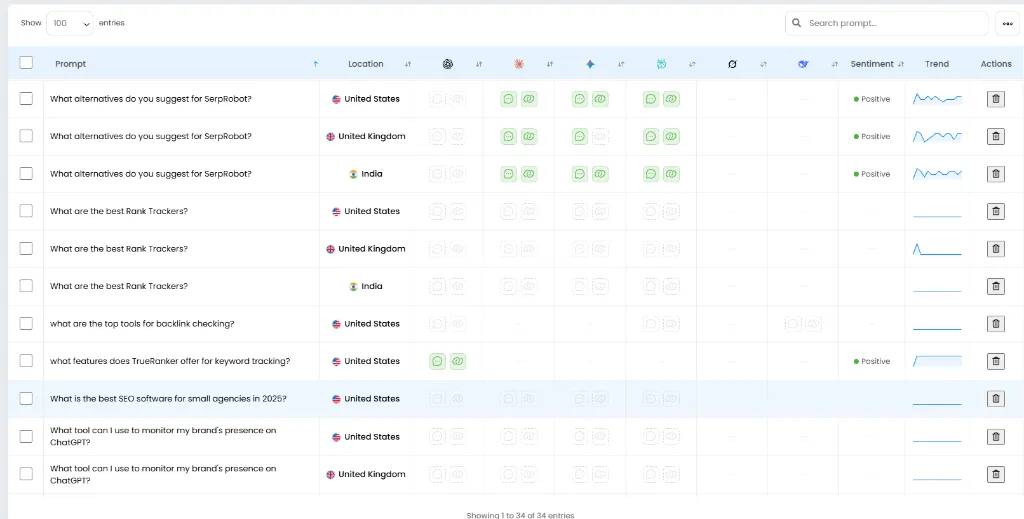
Bei breiten Kategorie-Prompts wie „What are the best Rank Trackers?“ blieb die Sichtbarkeit über die verschiedenen Modelle hinweg weitgehend flach. Der Grund: Allgemeine Fragen triggern Standardzusammenfassungen, die auf jahrelang gewachsenen Affiliate-Listen basieren.
Betrachtet man dagegen die Vergleichsanfrage ganz oben in der Liste („What alternatives do you suggest for SerpRobot?“), bot sich ein völlig anderes Bild: durchgehend positives Sentiment und aktive grüne Zitationsindikatoren in Claude, Gemini und Copilot.
Ein Klick in die Detailprüfung von ChatGPT für diese Abfrage in Großbritannien zeigte das entscheidende Muster:
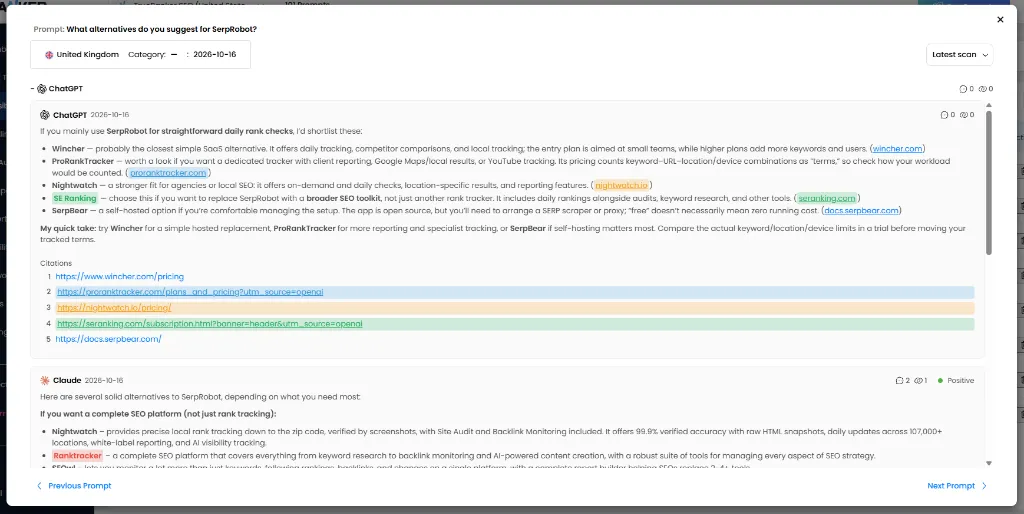
ChatGPT nannte nicht bloß Namen im Fließtext. Die Websuche des Modells setzte die Quellenverlinkungen direkt auf Tarif- und Preisseiten. Sieh dir die Zitate am Ende der Antwort an:
https://www.wincher.com/pricinghttps://proranktracker.com/plans_and_pricing?utm_source=openaihttps://nightwatch.io/pricing/https://seranking.com/subscription.html?banner=header&utm_source=openaihttps://docs.serpbear.com/
Zwei dieser Zitate tragen ausdrückliche utm_source=openai-Parameter. Das bedeutet: Die Suchmaschine von OpenAI hat gezielt Preisseiten gecrawlt, die Konditionen abgeglichen und dem wechselwilligen Nutzer direkte, klickbare Kauf-Links präsentiert.
Wenn du nur generische Branchenbegriffe im Blick behältst, entgeht dir genau der Moment, in dem Kaufentscheidungen in KI-Suchmaschinen fallen.
Lokale und transaktionale Suchanfragen
Diese Anfragen beantworten lokale oder sofortige Kaufentscheidungen, bei denen der Standort des Nutzers die Tool- oder Dienstleister-Empfehlung bestimmt.
Sie enthalten meist geografische Vorgaben:
- „Welche technischen SEO-Agenturen in München sind auf Shopify spezialisiert?“
- „Wo kann ich tägliche Rankings im Google Local Pack für mehrere Städte gleichzeitig überwachen?“
KI-Assistenten greifen für solche Abfragen auf lokale Unternehmensverzeichnisse und Webquellen zurück. Um diese Prompts sauber zu überwachen, musst du deine Tests gezielt nach Land und Stadt segmentieren, um regionale Unterschiede bei den Zitaten aufzudecken.
Schritt 3: Quellen der KI-Suchmaschinen im Live-Web analysieren
KI-Suchmaschinen erfinden empfohlene Marken nicht frei; sie ziehen Live-Informationen aus einem festen Set an Webquellen heran, bevor sie ihre Antwort generieren. Wenn Plattformen wie Perplexity, SearchGPT oder Gemini eine Nutzerfrage beantworten, blenden sie Fußnoten oder Quell-Badges ein. Das genaue Protokollieren dieser Quellen offenbart dir das Zitationsnetzwerk hinter der jeweiligen Suchanfrage:
- Kandidaten-Prompts in vernetzten KIs testen: Schicke deine 30 wichtigsten Prompts durch Perplexity, ChatGPT Search und Google AI Overviews.
- Häufig verlinkte Domains dokumentieren: Notiere, ob die Modelle Fachblogs, Reddit-Threads, offizielle Dokumentationen oder Branchenvergleiche heranziehen.
- Muster erkennen: Wenn vier von fünf Durchläufen Vergleichsartikel aus Fachmedien oder dedizierte Landingpages zitieren, benötigt deine Website Inhalte mit vergleichbarer Tiefe oder eine Präsenz in diesen Quellen.
- Prompts ohne Websuche aussortieren: Wenn eine Frage rein aus dem statischen Trainingswissen des Modells beantwortet wird, ohne das Web zu durchsuchen, ist ein kontinuierliches Zitations-Tracking unzuverlässig. Fokussiere dich auf Prompts, die reproduzierbar externe Webquellen abrufen.
Diese Mechanismen sind der Kern der Ranking-Faktoren in der KI-Suche, bei denen die Relevanz der abgerufenen Quellen unmittelbar darüber entscheidet, wer das Zitat erhält.
Schritt 4: Prompts durch statistische Häufigkeitstests validieren
Ein Prompt ist erst dann valide, wenn du ihn 60 bis 100 Mal abfragst und misst, mit welcher Wahrscheinlichkeit deine Marke tatsächlich zitiert wird. Da generative Sprachmodelle probabilistisch arbeiten, besitzt ein manueller Test mit ein oder zwei Abfragen keinerlei statistische Aussagekraft.
In unseren Messungen kann ein ungeprüfter Prompt eine Marke an einem Dienstagmorgen erwähnen und am Mittwochnachmittag komplett ausblenden. Ursache dafür sind die Temperatur des Modells, variierende Seeds und dynamische Aktualisierungen der durchsuchten Web-Indizes.
Statistische Konfidenz für Prompts:
  1 Testlauf:          ~10% bis 20% statistische Konfidenz (Keine Aussagekraft)
  10 Testläufe:        ~50% Konfidenz (Hohe Varianz)
  60 bis 100 Testläufe: >95% Konfidenz (Verlässliche geschäftliche Basis)
Bei dieser Auswertung musst du zwei Kennzahlen strikt voneinander trennen:
- Markenerwähnungsrate (Brand Mention Rate): Der prozentuale Anteil der Durchläufe, in denen das Modell den Namen deines Unternehmens im Antworttext nennt.
- Domain-Zitationsrate (Domain Citation Rate): Der prozentuale Anteil der Tests, bei denen die KI einen anklickbaren Link direkt auf deine Website als Quellenangabe setzt.
Eine reine Erwähnung schafft Bekanntheit, aber erst das Zitat bringt qualifizierten Referral-Traffic und echte Leads auf deine Website. Wenn ein Prompt eine Erwähnungsrate von 40 % erzielt, die Zitationsrate nach 80 Tests jedoch bei 0 % liegt, weißt du: Das Modell kennt deine Marke, findet auf deiner Website aber keine sauber strukturierte URL, die es als Beleg verlinken kann.
Möchtest du diese Tests automatisieren? 100 Abfragen manuell über fünf verschiedene KI-Plattformen zu jagen, kostet etliche Stunden und verbraucht unnötig API-Guthaben. Mit unserem Tool für KI-Sichtbarkeit kannst du Prompts und Zitationsraten automatisiert überwachen und erhältst saubere probabilistische Trendkurven ohne eigene Skripte.
Schritt 5: Nach semantischen Facetten clustern und Inhalte für KI-Chunking strukturieren
Unterteile validierte Prompts in informationelle und transaktionale Facetten und platziere direkte Antworten von 1 bis 2 Sätzen direkt unter jeder H2- und H3-Überschrift. Sobald deine bereinigte Prompt-Liste steht, ordnest du sie in logische Themenblöcke ein, die deinen Redaktionsplan strukturieren.
Wir unterscheiden zwei operative Hauptfacetten:
- Informationelle Facetten: Fragen zu Begriffen, technischem Aufbau, Fehlerbehebungen und Best Practices. Sie gehören in strukturierte Blogbeiträge und Hilfe-Center.
- Transaktionale Facetten: Suchen nach Preisen, Datenmigrationen, Feature-Gegenüberstellungen und Software-Alternativen. Sie gehören auf Produktseiten und dedizierte Vergleichs-Landings.
Damit Retrieval-Systeme deine Inhalte mühelos extrahieren können (Chunking-Optimierung), gehört eine präzise, eigenständige Antwort von 1 bis 2 Sätzen unmittelbar unter jede H2- und H3-Zwischenüberschrift. Verzichte auf einleitende Füllsätze. Wenn ein KI-Crawler dein Dokument in semantische Chunks zerlegt, liefert dieser Einstiegssatz genau das Zitat, das das Sprachmodell für seine Antwort benötigt.
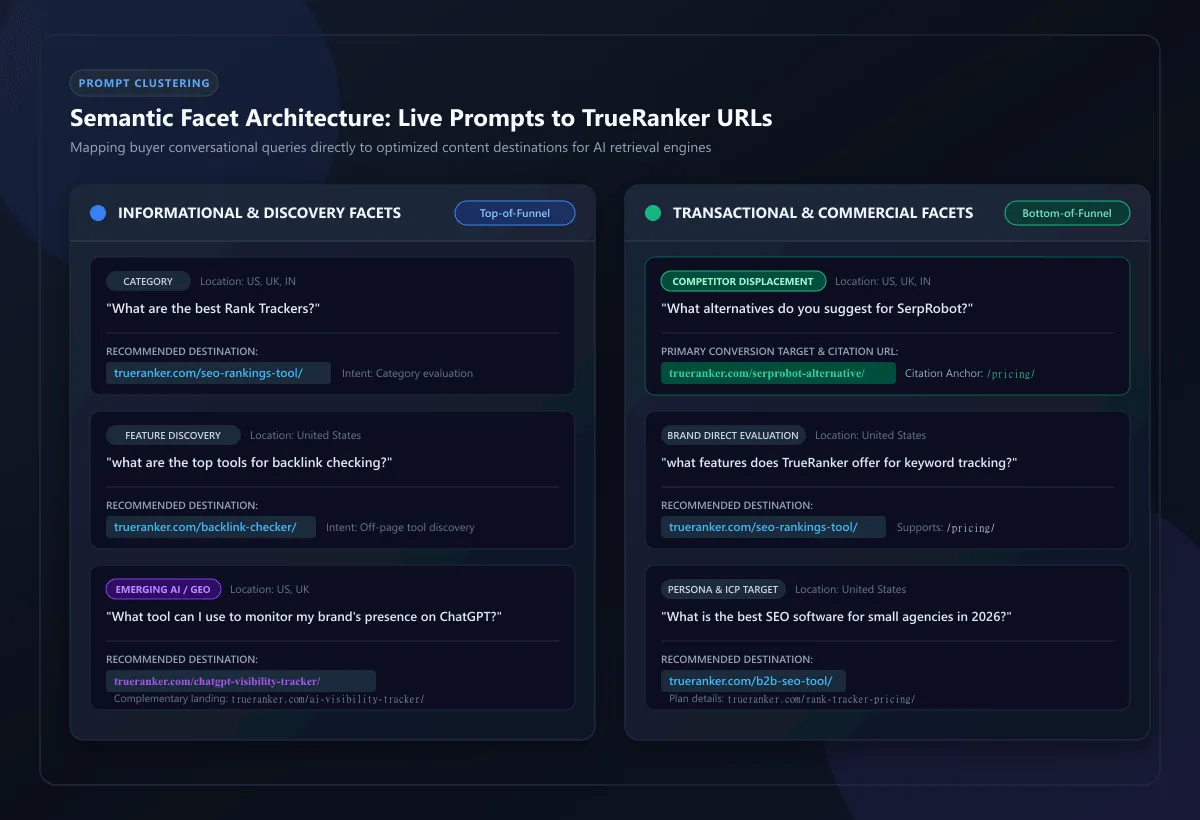
Die folgende Übersicht zeigt, wie wir die konkreten Prompts aus unserem Dashboard-Scan den passenden Facetten, Absichten und Ziel-URLs bei TrueRanker zuordnen:
| Getrackter Prompt | Semantische Facette | Kaufabsicht | Ziel-URL bei TrueRanker | Überschrift für KI-Extraktion (Chunk) |
|---|---|---|---|---|
| „What alternatives do you suggest for SerpRobot?“ | Transaktional | Wettbewerber-Ablösung (Bottom-of-Funnel) | /de/alternative-zu-serprobot/ & /de/preise/ |
Warum TrueRanker die direkteste Alternative zu SerpRobot ist |
| „What are the best Rank Trackers?“ | Informationell / Kategorie | Allgemeine Marktevaluation (Top-of-Funnel) | /de/ranking-tool/ |
Was ein modernes Rank-Tracking-Tool 2026 können muss |
| „what are the top tools for backlink checking?“ | Informationell / Recherche | Entdeckung ergänzender Funktionen | /de/kostenloser-backlink-checker/ |
Backlinks in Echtzeit analysieren ohne teure Enterprise-Kosten |
| „what features does TrueRanker offer for keyword tracking?“ | Transaktional | Direkte Marken- und Feature-Prüfung | /de/ranking-tool/ |
Zentrale Funktionen für das Keyword-Monitoring in TrueRanker |
| „What is the best SEO software for small agencies in 2026?“ | Transaktional / Agentur-Profil | Zielgruppen-Entscheidung für Agenturen | /de/seo-tool-agenturen/ |
Warum SEO-Agenturen TrueRanker Tools mit starren Nutzerlizenzen vorziehen |
| „What tool can I use to monitor my brand’s presence on ChatGPT?“ | Neue KI-Suche / GEO | KI-Markenmonitoring und Reputationsmessung | /de/chatgpt-sichtbarkeit/ |
So überwachst du Erwähnungen und Zitate deiner Marke in ChatGPT |
Prompt-Tracking ohne manuelle Skripte automatisieren
Eine spezialisierte Plattform übernimmt das tägliche Monitoring über mehrere KI-Modelle hinweg, ohne dass du eigene Scraping-Skripte oder API-Kosten verwalten musst. Dutzende Prompts manuell über ChatGPT, Claude, Gemini und Perplexity zu verfolgen, ist für wachsende Unternehmen und Agenturen im Alltag nicht machbar.
Ein eigenes Setup aufzubauen erfordert rotierende Proxys, das mühsame Parsen unstrukturierter Markdown-Ausgaben und hohe API-Rechnungen, die bei 100 Testläufen pro Prompt schnell eskalieren. Zudem spiegeln Entwickler-APIs selten das exakte Websuchverhalten der echten Benutzeroberflächen wie ChatGPT Search wider.
Genau dafür haben wir das Tool für ChatGPT-Sichtbarkeit und den KI-Sichtbarkeitsindex in TrueRanker integriert (für einen schnellen Vorab-Check ohne Konto kannst du auch jederzeit deine KI-Sichtbarkeit prüfen mit dem kostenlosen KI-Sichtbarkeits-Checker). Statt manueller Tabellen übernimmt die Plattform den gesamten Workflow:
- Automatische Prompt-Vorschläge: Findet relevante Konversationsfragen für deine Branche basierend auf echtem Suchverhalten.
- Kontinuierliches Multi-Modell-Monitoring: Prüft regelmäßig ChatGPT, Claude, Gemini, Copilot und Perplexity aufgeschlüsselt nach Ländern.
- Sentiment- und Zitationsanalyse: Zeigt dir, ob deine Marke positiv, neutral oder negativ dargestellt wird und wann ein Wettbewerber dir Zitate abnimmt.
- Berechnung des Share of Voice: Misst genau, wie viel Prozent der Antworten in deiner Kategorie deine Marke im Vergleich zur Konkurrenz anführen.
Alle Kontingente und Details findest du übersichtlich auf unserer Preisseite – flexibel anpassbar an deine Projekte, ganz ohne langfristige Vertragsbindung.
Häufig gestellte Fragen (FAQ)
Wie viele Prompts sollte ich zu Beginn tracken?
Starte am besten mit 20 bis 40 Prompts, aufgeteilt zu gleichen Teilen in kommerzielle Vergleichsanfragen und konkrete Problemfragen. Eine fokussierte Auswahl schont dein Budget und schafft eine verlässliche Datenbasis für deine Zitate, bevor du in speziellere Nischenfragen gehst.
Ist Prompt-Tracking sinnvoll, wenn jeder Nutzer ChatGPT anders fragt?
Ja, denn Sprachmodelle ordnen tausende individuelle Formulierungen denselben semantischen Absichten und Abfrageaufgaben zu. Du musst nicht jede Wortvariante einzeln überwachen; das Tracking des zentralen Prompts zeigt dir verlässlich, wie die KI das gesamte Themenfeld beantwortet.
Was ist der Unterschied zwischen einer Markenerwähnung und einem KI-Zitat?
Eine Markenerwähnung liegt vor, wenn das Modell deinen Firmen- oder Produktnamen im Antworttext ausschreibt. Ein Zitat hingegen ist ein klickbarer Link in den Quellennachweisen. Nur Zitate bringen qualifizierten Traffic und belegen, dass die KI deine Website als Faktengrundlage genutzt hat.
Wie oft sollte ich meine Prompt-Tracking-Liste aktualisieren?
Wir empfehlen, die Liste alle 30 bis 60 Tage zu überprüfen. Sortiere Prompts aus, die keine Websuche mehr auslösen, und nimm neue Fragen auf, die Interessenten an dein Vertriebsteam herangetragen haben. Da sich die KIs und der Content deiner Wettbewerber ständig weiterentwickeln, verschieben sich auch die Nutzerfragen mit der Zeit.
Erfahre, was KI-Assistenten über deine Marke sagen
TrueRanker identifiziert die echten Fragen deiner Zielgruppe und überwacht deine Erwähnungen und Zitate in ChatGPT, Perplexity, Claude und Gemini automatisch.
Geschrieben von
Javier Quevedo
Mitgründer & CEO, SEO Lead
Javier hat TrueRanker mitgegründet und führt Frontend, öffentliche Website und die letzte Meile zwischen einem Ranking in der Datenbank und dem Screen, den ein SEO wirklich nutzt. Seit Jahren macht er aus GEO, Local SEO, On-Page und KI-Sichtbarkeit Produkt — und die Guides in diesem Blog — damit Agenturen ChatGPT-Zitationen so messen wie Google. Er arbeitet auch am Backend: eine saubere Oberfläche über alten Daten ist reine Augenwischerei.
Das könnte Sie interessieren
Was ist llms.txt: Was die Daten sagen und ob du die Datei wirklich brauchst
Was bringt llms.txt wirklich? Drei Studien zu KI-Zitaten, der Unterschied zu robots.txt und wann sich die Datei für Websites lohnt. Daten statt Hype.
Javier Quevedo13 Min. Lesezeit
Beitrag lesenDie Checkliste zur KI-Suchoptimierung, die ich durchgehe, bevor ich eine Seite ändere.
Mit der Checkliste zur KI-Suchoptimierung nimmst du einen Prompt, prüfst Zitat oder Erwähnung und schaust, ob die Seitenänderung etwas gebracht hat.
Javier Quevedo10 Min. Lesezeit
Beitrag lesenRanking-Faktoren in der KI-Suche zählen erst, wenn sich das Zitat ändert.
Warum eine Seite in ChatGPT oder Perplexity zitiert wird und eine andere nicht: Ranking-Faktoren in der KI-Suche – und was ich an einem Prompt prüfe.
Javier Quevedo11 Min. Lesezeit
Beitrag lesen