Comment trouver et choisir les bons prompts pour votre visibilité IA
Comment choisir vos prompts de visibilité IA : simulez vos acheteurs, validez 100 requêtes et découvrez les questions qui génèrent de vraies citations.

Vous connaissez sans doute cette frustration : vous ouvrez ChatGPT, vous lui demandez quel est le meilleur outil de votre secteur, et vous voyez le modèle recommander trois de vos concurrents tout en ignorant complètement votre marque. Vous relancez la même question une minute plus tard et la réponse change. Vous réessayez le lendemain et les sources citées sont encore différentes.
Si vous abordez le suivi de prompts en IA comme un suivi de mots-clés classique, vous allez perdre des semaines à accumuler des données inutilisables. Les modèles de langage ne fonctionnent pas avec des volumes de recherche mensuels fixes et ne renvoient pas une liste immuable de résultats. Ce sont des moteurs probabilistes qui synthétisent chaque réponse à partir de recherches web en direct, d’interrogations vectorielles et de leur propre raisonnement interne.
Pour bâtir une stratégie de visibilité IA qui génère un véritable impact commercial, vous devez découvrir les questions conversationnelles exactes que posent vos acheteurs réels, mesurer leur consistance statistique et identifier les requêtes qui déclenchent des citations directes vers votre domaine. Voici la méthode en cinq étapes que nous appliquons pour trouver, valider et suivre les bons prompts en recherche IA.
Pourquoi le suivi de prompts n’a rien à voir avec une recherche de mots-clés classique
Suivre des prompts est une démarche radicalement différente de la recherche de mots-clés traditionnelle, car les requêtes conversationnelles déclenchent une décomposition en sous-requêtes multiples et une synthèse probabiliste en temps réel, au lieu d’interroger un index statique. Le moteur d’IA analyse les nuances de la demande de l’utilisateur, explore le web en direct, évalue les passages récupérés et rédige une réponse inédite à chaque exécution.
Lorsque quelqu’un saisit meilleur outil suivi de positions dans Google, le moteur confronte la requête à son index inversé. Tous les utilisateurs situés dans la même zone géographique voient des résultats pratiquement identiques. En revanche, lorsqu’un décideur demande des recommandations à ChatGPT ou Perplexity, l’assistant analyse ses contraintes spécifiques, consulte des sources web de référence et construit un comparatif sur mesure.
Trois différences fondamentales séparent l’analyse de prompts du SEO traditionnel :
- Absence de volume de recherche mensuel fixe : Les outils classiques vous indiquent qu’un mot-clé enregistre 2 400 recherches par mois. Les prompts n’ont pas de volume fixe, car les conversations humaines admettent une infinité de variations sémantiques. Vous suivez des intentions d’achat et des besoins concrets, pas des chaînes de caractères exactes.
- Contextualisation et décomposition de requête (query fan-out) : Un prompt comme « Quelles alternatives me conseillez-vous à SerpRobot pour une agence gérant 50 clients locaux ? » force le modèle à lancer plusieurs recherches simultanées en coulisses (comparatifs de tarifs, gestion multi-comptes ou génération de rapports clients).
- Dérive probabiliste des citations : Dans la recherche classique, une URL en troisième position reste généralement stable pendant des jours ou des semaines. Dans les modèles de langage, une marque citée lors du premier test peut disparaître au troisième si la requête n’a pas été validée statistiquement sur des exécutions répétées.
| Critère d’évaluation | Suivi classique de mots-clés | Suivi de prompts pour LLM |
|---|---|---|
| Volume de recherche | Estimations mensuelles fixes (Ahrefs, GSC) | Aucun volume figé ; groupes d’intentions conversationnelles |
| Format du résultat | Liste ordonnée de liens bleus (1 à 10) | Prose synthétisée, tableaux comparatifs et liens de citation |
| Stabilité | Positions relativement stables au quotidien | Probabiliste ; réponses et sources variables selon l’exécution |
| Actif de conversion | Position organique en première page | Mention mise en valeur et lien de citation vers le site |
| Mécanisme de recherche | Requête unique sur un index inversé | Décomposition en sous-requêtes, extraction web et synthèse |
| Objectif prioritaire | Capter des clics organiques sur les SERP | Obtenir des recommandations de marque et des citations d’URL |
Étape 1 : Définissez le contexte opérationnel de votre projet et le profil de vos acheteurs
Avant de demander des idées de prompts à un modèle de langage, vous devez lui fournir un cadre opérationnel précis incluant le profil de votre acheteur cible, votre offre, vos objections récurrentes et le vocabulaire réel de vos clients. Si vous interrogez une IA sans ce contexte préalable, elle ne produira que des listes de questions génériques qu’aucun acheteur réel ne formulerait jamais.
Lors des audits que je mène avec des fondateurs et des équipes marketing, je commence toujours par analyser les enregistrements d’appels commerciaux, les tickets de support et les notes du CRM. Vos clients réels ne posent presque jamais de questions encyclopédiques comme « Qu’est-ce qu’un logiciel SEO ? ». Ils formulent des demandes précises ancrées dans leurs frictions quotidiennes :
- Secteur et taille d’entreprise : Un consultant indépendant ne cherche pas de la même manière que le responsable d’une agence comptant 20 spécialistes.
- Frictions et goulots d’étranglement : Tarification par utilisateur prohibitive, hausses de prix brutales lors des changements de palier, absence de suivi local précis sur Google Maps ou rafraîchissement trop lent des positions.
- Objections commerciales fréquentes : « Pourquoi devrais-je payer pour cet outil alors que j’ai déjà Google Search Console ? » ou « Comment exporter facilement ces données dans mes rapports mensuels ? ».
- Critères indispensables : Rapports en marque blanche pour les clients, précision locale au niveau du code postal ou suivi multi-modèles en IA.
Fournissez ce contexte complet au modèle avant de lancer vos simulations. Dès lors que l’IA comprend les spécificités de votre marché, les questions qu’elle génère reflètent fidèlement les échanges réels d’une phase d’achat.
Étape 2 : Appliquez l’ingénierie inverse à l’intention d’achat par la simulation
L’ingénierie inverse de l’intention d’achat consiste à demander à des modèles de raisonnement avancé d’adopter la posture de votre client idéal et de simuler ses interrogations tout au long de sa prise de décision. Plutôt que de deviner ce qu’un internaute pourrait taper, vous amenez le modèle à reproduire son cheminement mental, de la prise de conscience du problème jusqu’au comparatif final des prestataires.
Pour cet exercice, j’utilise des modèles dotés de capacités de raisonnement approfondi (comme OpenAI o3, Claude 3.7 Sonnet ou Gemini 2.0 Pro) en leur soumettant une consigne de simulation détaillée :
« Agis comme le responsable SEO d’une agence spécialisée qui gère 30 clients locaux. Tu es lassé des outils imposant une facturation par utilisateur abusive et des plateformes vieillissantes qui n’intègrent pas la recherche IA. Rédige 15 questions concrètes et conversationnelles que tu poserais à ChatGPT ou Perplexity pour trouver, comparer et justifier le passage à un outil plus moderne. »
Cette simulation fait émerger des prompts répartis en trois phases commerciales bien distinctes :
Prompts orientés vers les symptômes et points de douleur
Ces prompts de friction interviennent lorsqu’un professionnel rencontre une anomalie technique ou une baisse de trafic et se tourne vers un assistant IA pour en comprendre la cause.
Ils commencent généralement par exposer directement le problème :
- « Pourquoi Google Search Console n’affiche-t-il pas les mêmes positions de mots-clés que les outils externes de suivi de positions ? »
- « Pourquoi le trafic organique de mon site diminue-t-il alors que mes positions sur Google restent stables ? »
- « Comment savoir si ChatGPT cite mes concurrents plutôt que mon domaine ? »
Être cité dans ces réponses vous positionne comme une référence technique avant même que l’acheteur n’entame l’évaluation de marques précises.
Prompts commerciaux et comparatifs entre concurrents
Les prompts commerciaux et comparatifs correspondent au moment où le client potentiel évalue différentes solutions et demande au modèle de confronter des outils spécifiques.
Ces questions concentrent vos opportunités au taux de conversion le plus élevé :
- « Quel est le meilleur outil SEO pour les petites agences en 2026 ? »
- « Quelles alternatives recommandez-vous à SerpRobot ? »
- « Wincher vs ProRankTracker vs TrueRanker : lequel est le plus efficace pour le suivi local ? »
Voici un cas réel extrait de notre propre tableau de bord qui illustre pourquoi les requêtes comparatives surpassent largement les recherches de catégorie génériques.
La semaine dernière, en observant les analyses de suivi que nous menons aux États-Unis, au Royaume-Uni et en Inde, j’ai relevé un contraste frappant entre deux typologies de requêtes :
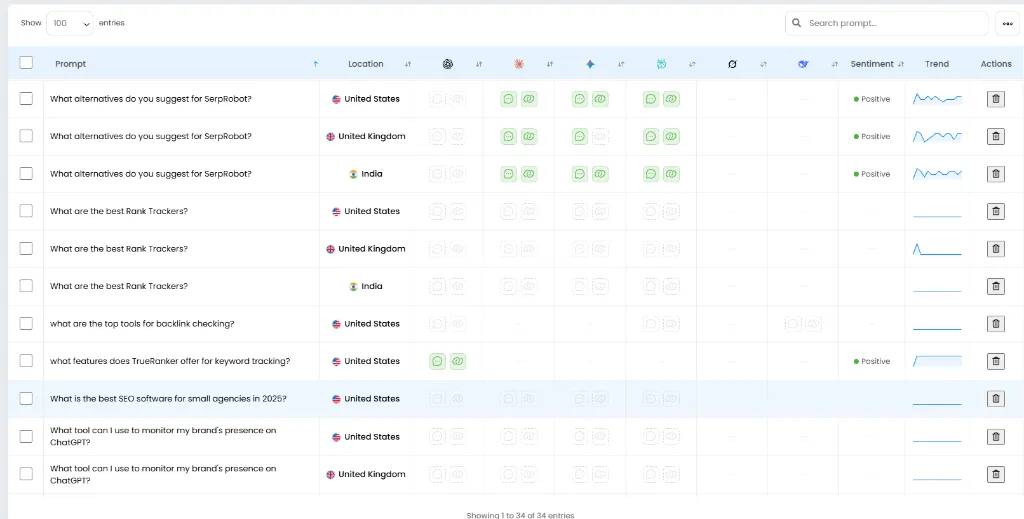
Sur des prompts de catégorie large comme « What are the best Rank Trackers? », la visibilité variait très peu d’un modèle à l’autre. L’explication ? Ces requêtes renvoient des synthèses basées sur de vieux articles d’affiliation présents sur le web depuis des années.
En revanche, sur le prompt de remplacement de concurrent figurant en tête de liste (« What alternatives do you suggest for SerpRobot? »), la dynamique était tout autre : le sentiment était nettement positif et les citations ressortaient en vert sur Claude, Gemini et Copilot.
En consultant le détail de l’analyse de ChatGPT pour cette requête au Royaume-Uni, le constat est sans équivoque :
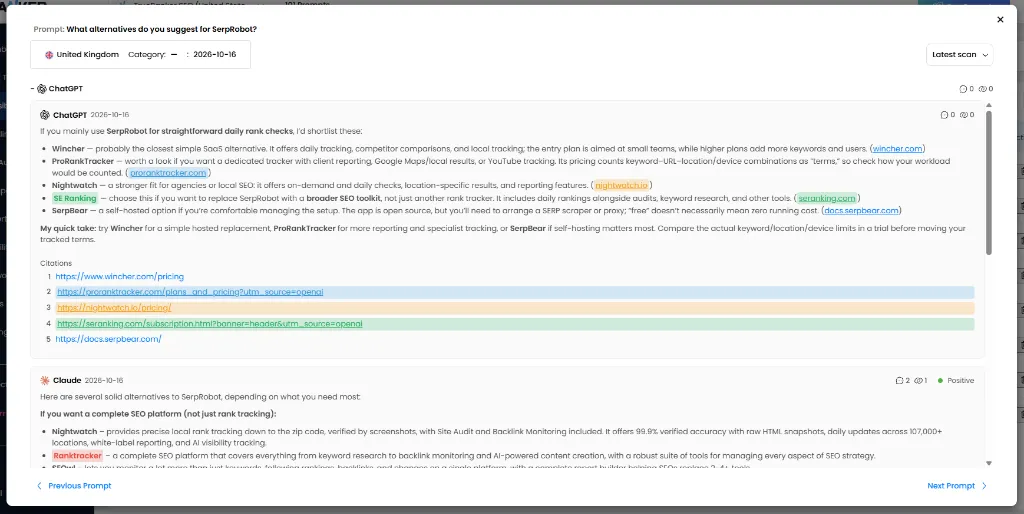
ChatGPT ne s’est pas contenté de nommer des marques dans son texte ; son moteur de recherche web a extrait des citations directes vers les pages de tarification. Observez les liens placés au bas de sa réponse :
https://www.wincher.com/pricinghttps://proranktracker.com/plans_and_pricing?utm_source=openaihttps://nightwatch.io/pricing/https://seranking.com/subscription.html?banner=header&utm_source=openaihttps://docs.serpbear.com/
Deux de ces citations comportent des paramètres de tracking explicites utm_source=openai. Cela prouve que le robot d’OpenAI a exploré ces pages de prix, a analysé leurs formules et a affiché des liens directs et cliquables à un acheteur qui cherchait activement à remplacer son outil actuel.
Si vous ne suivez que des requêtes génériques, vous passez à côté de l’endroit précis où se prennent les décisions d’achat dans la recherche conversationnelle.
Requêtes de proximité et transactions locales
Les requêtes transactionnelles avec facteur de proximité répondent à des besoins immédiats où la localisation ou la couverture géographique conditionne la recommandation.
Elles intègrent souvent des filtres territoriaux :
- « Quelles sont les agences de SEO technique les mieux notées à Lyon pour les sites e-commerce ? »
- « Quel outil permet de suivre les positions quotidiennes dans le Pack Local de Google sur plusieurs villes à la fois ? »
Les assistants d’IA consultent des sources web locales et des bases géographiques pour répondre à ces demandes. Pour les suivre rigoureusement, vous devez segmenter vos tests par pays et par ville afin d’isoler les variations régionales de citations.
Étape 3 : Analysez les sources d’extraction des moteurs d’IA connectés au web
Analyser les sources d’extraction consiste à tester vos prompts candidats sur des moteurs d’IA ayant accès à internet afin d’identifier quels médias, forums et annuaires alimentent leurs citations. Les modèles n’inventent pas les prestataires recommandés ; ils collectent leurs données en direct auprès d’un ensemble spécifique de publications avant de formuler leur réponse.
Lorsque des plateformes comme Perplexity, SearchGPT ou Gemini répondent à une question, elles affichent des références sous forme de notes de bas de page ou de badges interactifs. Documenter ces sources vous révèle la cartographie exacte de la visibilité sur cette thématique :
- Testez vos prompts candidats sur des moteurs connectés : Passez votre liste initiale de 30 requêtes dans Perplexity, ChatGPT Search et les AI Overviews de Google.
- Relevez les domaines cités de façon récurrente : Vérifiez si le moteur appuie sa réponse sur des avis indépendants, des fils Reddit, de la documentation technique ou des comparatifs de blogs spécialisés.
- Identifiez les schémas d’indexation : Si dans quatre tests sur cinq le modèle cite des articles comparatifs de blogs d’experts ou des pages d’atterrissage produit, votre site doit proposer des contenus d’une profondeur équivalente ou figurer sur ces médias de référence.
- Écartez les prompts sans recherche web : Si une requête se contente d’exploiter les connaissances internes du modèle sans lancer de recherche externe, il sera impossible d’y mesurer des citations d’URL. Concentrez-vous sur les prompts qui déclenchent systématiquement des requêtes web.
Comprendre ce mécanisme d’extraction est déterminant pour maîtriser les facteurs de classement en recherche IA, où la pertinence des sources consultées dicte quelles marques obtiennent des liens visibles.
Étape 4 : Validez la consistance de chaque prompt par des tests statistiques
La validation statistique permet de vérifier si un prompt offre une visibilité régulière pour votre marque en exécutant cette requête entre 60 et 100 fois pour calculer sa probabilité réelle de citation. Les modèles génératifs étant probabilistes, tester un prompt une ou deux fois n’offre aucune fiabilité.
Dans nos analyses internes, un prompt non validé peut très bien citer une marque un mardi matin et l’ignorer complètement le mercredi après-midi. Cette variabilité découle de la température du modèle, des variations d’amorçage (seed) et des mises à jour constantes des index de recherche web.
Seuils de fiabilité statistique d’un prompt :
  1 test manuel :      ~10 % à 20 % de confiance statistique (Aucune valeur analytique)
  10 tests :           ~50 % de confiance (Forte variance)
  60 à 100 tests :     >95 % de confiance (Base de référence commerciale fiable)
Durant cette phase de validation, vous devez impérativement distinguer deux indicateurs complémentaires :
- Taux de mention de marque (Brand Mention Rate) : Pourcentage de requêtes où le modèle nomme votre entreprise ou votre produit dans le corps de son texte.
- Taux de citation de domaine (Domain Citation Rate) : Pourcentage d’exécutions où le moteur intègre un lien cliquable vers votre site web parmi ses sources de référence.
Une mention de marque développe la notoriété passive, mais seule une citation de domaine redirige un trafic qualifié directement vers votre tunnel de conversion. Si un prompt enregistre 40 % de mentions mais 0 % de citations après 80 passages, cela signifie que le modèle reconnaît votre entité, mais ne trouve aucune URL suffisamment claire et structurée à citer comme source de données.
Vous souhaitez automatiser ces tests sans y consacrer des heures ? Évaluer 100 requêtes manuellement sur cinq plateformes d’IA différentes prend un temps considérable et consomme rapidement vos crédits d’API. Vous pouvez mesurer votre visibilité conversationnelle et vos taux de citation de manière automatisée avec notre module de visibilité IA, et obtenir des statistiques probabilistes claires sans rédiger une seule ligne de script.
Étape 5 : Regroupez par facettes sémantiques et structurez votre contenu pour l’extraction IA
Regrouper vos prompts validés en facettes informationnelles et transactionnelles vous permet d’adapter la structure de vos pages avec des blocs de réponse directe, afin que les robots d’IA puissent extraire et citer vos contenus sans friction. Une fois votre liste de requêtes épurée, classez-les en ensembles logiques qui guideront votre calendrier éditorial.
Nous répartissons généralement les prompts selon deux facettes principales :
- Facettes informationnelles : Questions sur des concepts, comparatifs d’architecture technique, dépannage et guides méthodologiques. Elles ont naturellement leur place sur un blog ou dans un centre d’aide.
- Facettes transactionnelles : Demandes de tarifs, démarches de migration entre outils, fonctionnalités comparées et alternatives commerciales. Elles doivent être traitées sur des pages produit et des pages comparatives dédiées.
Pour que les moteurs d’extraction puissent citer vos textes sans difficulté (optimisation par fragments ou chunking), rédigez une réponse directe et complète d’une à deux phrases immédiatement sous chaque titre H2 et H3. Évitez les formules creuses et les digressions introductives. Lorsque le robot d’un modèle découpe votre page en blocs sémantiques, cette réponse initiale lui fournit exactement la citation autonome dont il a besoin pour étayer sa réponse.
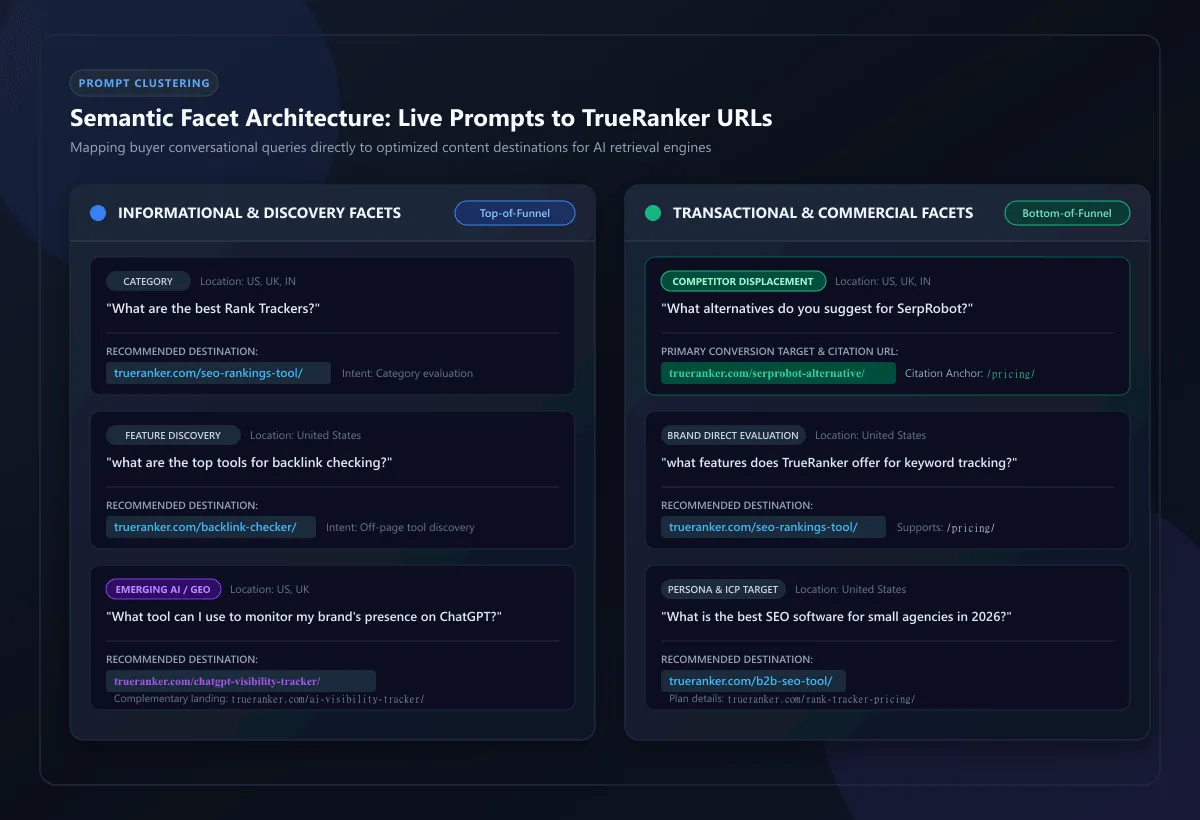
Le tableau suivant montre comment nous relions chaque prompt issu de nos analyses à sa facette, son intention d’achat et son URL de destination recommandée au sein de TrueRanker :
| Prompt analysé | Facette sémantique | Intention d’achat | URL recommandée sur TrueRanker | Titre pour extraction directe (Chunk) |
|---|---|---|---|---|
| « What alternatives do you suggest for SerpRobot? » | Transactionnelle | Remplacement de concurrent (Bas de tunnel) | /fr/alternative-a-serprobot/ & /fr/tarifs/ |
Pourquoi TrueRanker est l’alternative la plus directe à SerpRobot |
| « What are the best Rank Trackers? » | Informationnelle / Catégorie | Évaluation globale du marché (Haut de tunnel) | /fr/outil-suivi-de-positions/ |
Quelles fonctionnalités définissent un outil de suivi de positions moderne en 2026 |
| « what are the top tools for backlink checking? » | Informationnelle / Découverte | Évaluation d’une fonctionnalité complémentaire | /fr/backlink-checker-gratuit/ |
Auditer vos liens entrants en temps réel sans frais de niveau entreprise |
| « what features does TrueRanker offer for keyword tracking? » | Transactionnelle | Examen direct de la marque et de ses outils | /fr/outil-suivi-de-positions/ |
Les fonctionnalités clés du suivi de mots-clés dans TrueRanker |
| « What is the best SEO software for small agencies in 2026? » | Transactionnelle / Profil agence | Décision d’achat B2B pour équipes et agences | /fr/outil-seo-agences/ |
Pourquoi les agences choisissent TrueRanker face aux outils facturés par utilisateur |
| « What tool can I use to monitor my brand’s presence on ChatGPT? » | Émergente IA / GEO | Suivi de présence de marque et d’e-réputation en IA | /fr/visibilite-chatgpt/ |
Comment suivre les mentions et les citations de votre marque dans ChatGPT |
Comment automatiser le suivi des prompts sans développer de scripts internes
Automatiser le suivi de vos prompts via une plateforme dédiée supprime la complexité technique liée à la gestion des appels d’API et à la maintenance de robots d’extraction web. Suivre manuellement des dizaines de requêtes dans ChatGPT, Claude, Gemini et Perplexity est intenable pour une agence ou une entreprise en pleine croissance.
Développer un dispositif interne impose de mettre en place des proxys résidentiels tournants, d’analyser des réponses en markdown non structurées, de gérer les quotas de requêtes et de supporter des coûts d’API qui explosent dès qu’on applique 100 tests par prompt. En outre, les API pour développeurs ne reproduisent pas fidèlement l’expérience ni les recherches web des interfaces grand public comme ChatGPT Search.
C’est précisément pour cette raison que nous avons intégré le suivi de visibilité ChatGPT au sein de TrueRanker. Plutôt que d’alimenter des feuilles de calcul fastidieuses, l’outil gère l’ensemble du flux :
- Suggestions de prompts pertinentes : Détection des questions conversationnelles adaptées à votre marché à partir des requêtes réelles des utilisateurs.
- Suivi continu multi-modèles : Analyses planifiées sur ChatGPT, Claude, Gemini, Copilot et Perplexity avec ciblage par pays.
- Analyse du sentiment et des citations : Détection de la tonalité (positive, neutre ou négative) et alertes lorsqu’un concurrent prend votre place sur une citation.
- Calcul de la part de voix (Share of Voice) : Mesure exacte du pourcentage de réponses de votre secteur dans lesquelles votre marque est recommandée face à vos rivaux directs.
Vous pouvez consulter nos capacités de suivi et nos différentes formules sur notre page de tarifs, modulables selon vos besoins sans engagement contractuel contraignant.
Foire aux questions
Combien de prompts est-il conseillé de suivre pour démarrer ?
Il est judicieux de commencer avec un groupe de 20 à 40 prompts, répartis à parts égales entre requêtes de comparaison commerciale et questions axées sur des problèmes précis. Ce volume initial évite de disperser vos ressources et permet d’établir une première référence solide en termes de citations avant d’élargir le spectre.
Le suivi de prompts est-il pertinent si chaque internaute s’adresse différemment à ChatGPT ?
Oui, car les modèles de langage regroupent des milliers de formulations différentes sous les mêmes concepts sémantiques et les mêmes démarches d’extraction. Vous n’avez pas besoin de mesurer chaque tournure de phrase ; suivre le prompt central vous permet d’évaluer la manière dont le modèle traite l’ensemble de cette intention de recherche.
Quelle est la différence entre une mention de marque et une citation dans un moteur d’IA ?
Une mention de marque intervient lorsque le moteur cite le nom de votre produit dans le corps de sa réponse, tandis qu’une citation s’accompagne d’un lien actif et cliquable vers votre domaine dans les sources référencées. Seules les citations génèrent un trafic qualifié et prouvent que le modèle a exploité votre contenu pour fonder sa réponse.
À quelle fréquence convient-il de renouveler sa liste de prompts ?
Il est recommandé d’auditer votre sélection de prompts tous les 30 à 60 jours pour écarter les questions qui ne déclenchent pas de recherche sur le web et intégrer les nouvelles demandes relevées par vos équipes commerciales. À mesure que les moteurs d’IA actualisent leurs index et que vos concurrents publient de nouveaux contenus, les requêtes des utilisateurs évoluent naturellement.
Découvrez ce que les assistants IA disent de votre marque
TrueRanker identifie les questions réelles de vos acheteurs et suit vos citations dans ChatGPT, Perplexity, Claude et Gemini automatiquement.
Écrit par
Javier Quevedo
Cofondateur & CEO, SEO Lead
Javier a cofondé TrueRanker et dirige le frontend, le site public et le dernier kilomètre entre un ranking en base et l’écran qu’un SEO utilise vraiment. Depuis des années, il transforme GEO, SEO local, on-page et visibilité IA en produit — et en guides sur ce blog — pour que les agences mesurent les citations ChatGPT comme elles mesurent déjà Google. Il travaille aussi le backend : une interface propre sur des données périmées reste un mensonge.
Cela pourrait vous intéresser
Qu’est-ce que le fichier llms.txt : ce que disent les données et si vous en avez vraiment besoin
Qu’est-ce que llms.txt, que révèlent 3 études sur les citations IA et quand faut-il l’installer ? Analyse concrète et données fiables, sans hype.
Javier Quevedo15 min de lecture
Lire l’articleLa checklist d’optimisation pour la recherche IA que je passe avant de modifier une page.
Avec la checklist d’optimisation pour la recherche IA, vous prenez un prompt, voyez citation ou mention, et si modifier la page a servi à quelque chose.
Javier Quevedo11 min de lecture
Lire l’articleLes facteurs de visibilité IA ne comptent que si vous êtes cité.
Si un concurrent est cité par ChatGPT à votre place, c’est là qu’entrent en jeu les facteurs de visibilité IA. Voici ce que je vérifie sur un prompt.
Javier Quevedo14 min de lecture
Lire l’articlePourquoi votre classement Google ne dit rien de votre visibilité IA
Être 3e sur Google ne vous met pas dans la réponse de ChatGPT. Pourquoi les deux ont divergé et quoi mesurer à la place.
TrueRanker3 min de lecture
Lire l’article