Cómo elegir los prompts adecuados para monitorizar tu visibilidad en IA
Aprende a elegir prompts para monitorizar visibilidad en IA con intención de compra: de simular compradores a validar citas en ChatGPT con 60 consultas.

Seguro que conoces de sobra esta frustración: abres ChatGPT, preguntas por el mejor software de tu sector y ves cómo el modelo recomienda a tres de tus competidores mientras ignora por completo a tu marca. Vuelves a enviar la misma pregunta un minuto después y la respuesta cambia. Lo pruebas al día siguiente y las fuentes vuelven a ser distintas.
Si tratas la monitorización de prompts en IA igual que el seguimiento tradicional de palabras clave, vas a perder semanas acumulando datos inservibles. Los modelos de lenguaje no funcionan con volúmenes fijos de búsqueda mensual ni devuelven una lista estática de posiciones. Son motores probabilísticos que sintetizan cada respuesta a partir de búsquedas web en directo, consultas vectoriales y su propio razonamiento interno.
Para construir una estrategia de visibilidad en IA que de verdad mueva métricas de negocio, necesitas descubrir las preguntas conversacionales exactas que formulan tus compradores reales, comprobar su consistencia estadística y averiguar qué consultas disparan citas directas hacia tu web. Aquí tienes el marco de trabajo en cinco pasos que utilizamos para encontrar, validar y monitorizar los prompts adecuados en motores de búsqueda con IA.
Por qué rastrear prompts no tiene nada que ver con hacer un estudio de palabras clave
Rastrear prompts es un proceso completamente distinto al estudio clásico de palabras clave porque las búsquedas conversacionales activan una descomposición en varias subconsultas y una síntesis probabilística en tiempo real, en lugar de contrastar un término contra un índice estático. El motor de IA analiza los matices de la pregunta del usuario, busca información en la web en vivo, evalúa los fragmentos recuperados y redacta una respuesta nueva para cada ejecución.
Cuando alguien escribe mejor rank tracker en Google, el buscador contrasta la palabra clave contra un índice invertido. Casi todos los usuarios que buscan desde la misma ubicación ven resultados prácticamente idénticos. En cambio, cuando un comprador le pide recomendaciones de software a ChatGPT o Perplexity, el asistente interpreta sus necesidades concretas, acude a fuentes web de referencia y elabora una comparativa a medida.
Existen tres diferencias clave que separan la investigación de prompts de la analítica SEO tradicional:
- Ausencia de volumen de búsqueda mensual estático: Las herramientas clásicas te indican que una keyword tiene 2.400 búsquedas al mes. Los prompts carecen de esa métrica porque las conversaciones humanas admiten infinitas variaciones semánticas. Debes monitorizar intenciones de compra y tareas de búsqueda, no cadenas exactas de texto.
- Personalización del contexto y descomposición de consultas (query fan-out): Un prompt como “¿Qué alternativas me sugieres a SerpRobot para una agencia que gestiona 50 clientes locales?” obliga al modelo a lanzar múltiples consultas paralelas por debajo (comparativas de tarifas, soporte para ubicaciones múltiples o informes para clientes).
- Deriva probabilística en las citas: En la búsqueda clásica, una URL en tercera posición suele mantenerse en torno a ese puesto durante días o semanas. En los modelos de lenguaje, una marca citada en la primera prueba puede desaparecer en la tercera si el prompt no se ha validado estadísticamente en ejecuciones repetidas.
| Métrica de evaluación | Rastreo clásico de palabras clave | Monitorización de prompts en LLMs |
|---|---|---|
| Volumen de búsqueda | Estimaciones fijas al mes (Ahrefs, GSC) | Sin volumen fijo; clusters de intención conversacional |
| Formato de salida | Lista ordenada de enlaces azules (1 al 10) | Texto sintetizado, viñetas comparativas y enlaces de cita |
| Estabilidad | Posiciones relativamente estables día a día | Probabilística; respuestas y fuentes varían por ejecución |
| Activo de conversión | Posición orgánica en la primera página | Mención destacada y enlace de cita hacia la web |
| Mecanismo de búsqueda | Consulta simple contra un índice invertido | Descomposición en subconsultas, recuperación y síntesis web |
| Objetivo prioritario | Captar clics orgánicos desde las SERPs | Ganar recomendaciones de marca y citas de dominio |
Paso 1: Define el contexto operativo de tu proyecto y el perfil del comprador
Antes de pedirle ideas de prompts a un modelo de lenguaje, debes proporcionarle un marco operativo claro con el perfil de tu comprador objetivo, tus productos, tus objeciones habituales y el lenguaje real de tus clientes. Si haces preguntas a ciegas a una IA sin este contexto previo, solo obtendrás listados genéricos de preguntas que los compradores reales jamás escriben.
En las auditorías que hago con fundadores y equipos de marketing, siempre comienzo revisando transcripciones de llamadas comerciales, tickets de soporte y notas del CRM. Tus clientes de verdad casi nunca formulan dudas enciclopédicas como “¿Qué es un software de SEO?”. Plantean cuestiones muy específicas vinculadas a sus dolores diarios:
- Sector y tamaño de empresa: Un consultor independiente no busca de la misma manera que el director de una agencia con 20 especialistas.
- Fricciones y cuellos de botella: Límites de coste por usuario, tarifas con saltos de precio desproporcionados, falta de seguimiento en Google Maps o lentitud al refrescar posiciones.
- Objeciones comerciales frecuentes: “¿Por qué debería pagar por esto si ya tengo Google Search Console?” o “¿Cómo exporto estos datos a mis informes mensuales?”.
- Requisitos indispensables: Informes white-label para clientes, analítica local a nivel de código postal o seguimiento multimodelo en IA.
Introduce este contexto en tu sesión de trabajo antes de realizar simulaciones. Cuando el modelo entiende los límites de tu negocio, las preguntas que genera reproducen conversaciones reales de compra.
Paso 2: Aplica ingeniería inversa a la intención de compra mediante simulaciones
La ingeniería inversa de la intención de compra consiste en pedir a modelos de razonamiento avanzado que se pongan en el lugar de tu cliente ideal y simulen sus dudas a lo largo del proceso de decisión. En lugar de adivinar qué podría escribir un usuario, haces que el modelo reproduzca su proceso mental desde la detección del problema hasta la comparativa final de proveedores.
Para este ejercicio utilizo modelos con capacidad de razonamiento profundo (como OpenAI o3, Claude 3.7 Sonnet o Gemini 2.0 Pro) con una instrucción detallada de simulación:
“Actúa como el responsable de SEO de una agencia especializada que gestiona 30 clientes locales. Estás cansado de herramientas con tarifas por usuario abusivas y de plataformas antiguas que no miden búsquedas en IA. Escribe 15 preguntas concretas y conversacionales que le harías a ChatGPT o Perplexity para encontrar, comparar y justificar el cambio a una herramienta más moderna.”
Este tipo de simulación saca a la luz prompts distribuidos en tres fases comerciales muy claras:
Prompts orientados a síntomas y puntos de dolor
Los prompts de puntos de dolor capturan al usuario cuando sufre un contratiempo técnico o una caída de rendimiento y acude a un asistente de IA para entender el motivo.
Suelen arrancar describiendo el problema directo:
- “¿Por qué Google Search Console no muestra las mismas posiciones de palabras clave que las herramientas de rank tracking externas?”
- “¿Por qué ha caído el tráfico orgánico de mi web si las posiciones en Google se mantienen estables?”
- “¿Cómo puedo saber si ChatGPT cita a mis competidores en lugar de a mi dominio?”
Aparecer citado en estas respuestas te posiciona como referente técnico antes de que el comprador empiece a evaluar marcas concretas.
Prompts comerciales y comparativas entre competidores
Los prompts comerciales y comparativos se dan cuando el cliente potencial está analizando alternativas y le pide al modelo que compare herramientas específicas.
Estas preguntas concentran tus oportunidades con mayor tasa de conversión:
- “¿Cuál es el mejor software de SEO para pequeñas agencias en 2026?”
- “¿Qué alternativas recomiendas a SerpRobot?”
- “Wincher vs ProRankTracker vs TrueRanker: ¿cuál funciona mejor para seguimiento local?”
Te pongo un caso real de nuestro panel que demuestra por qué las consultas comparativas superan con creces a las búsquedas genéricas de categoría.
La semana pasada, al revisar las ejecuciones de seguimiento que tenemos activadas en Estados Unidos, Reino Unido e India, detecté un contraste evidente entre dos tipos de consultas:
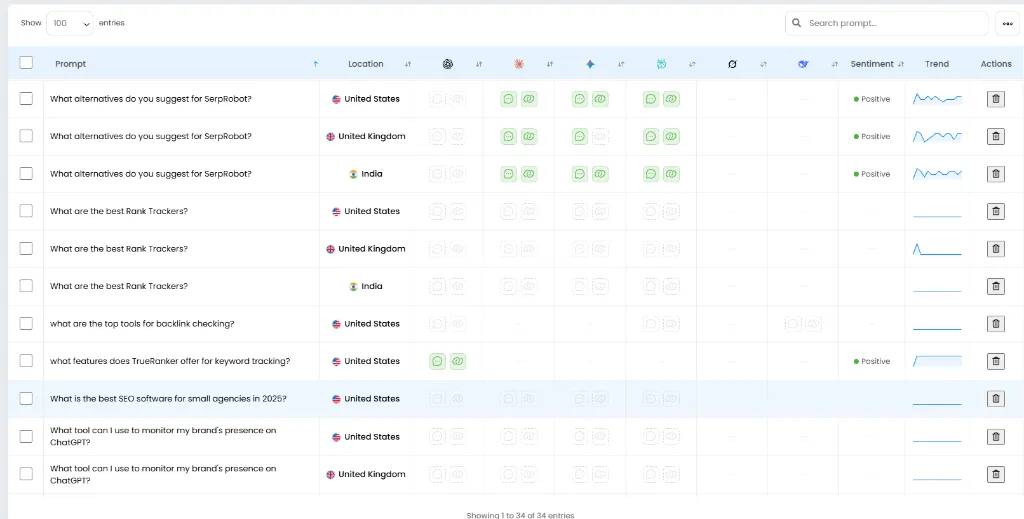
En los prompts de categoría amplia como “What are the best Rank Trackers?”, la visibilidad apenas registraba cambios entre modelos. ¿El motivo? Las consultas genéricas devuelven resúmenes basados en artículos de afiliados con años de antigüedad en la web.
Sin embargo, al observar el prompt de desplazamiento de competidores que encabeza la lista (“What alternatives do you suggest for SerpRobot?”), la situación era radicalmente distinta: mostraba un sentimiento positivo claro y citas verificadas en verde en Claude, Gemini y Copilot.
Al abrir el detalle del escaneo de ChatGPT para esa consulta en Reino Unido, el resultado fue concluyente:
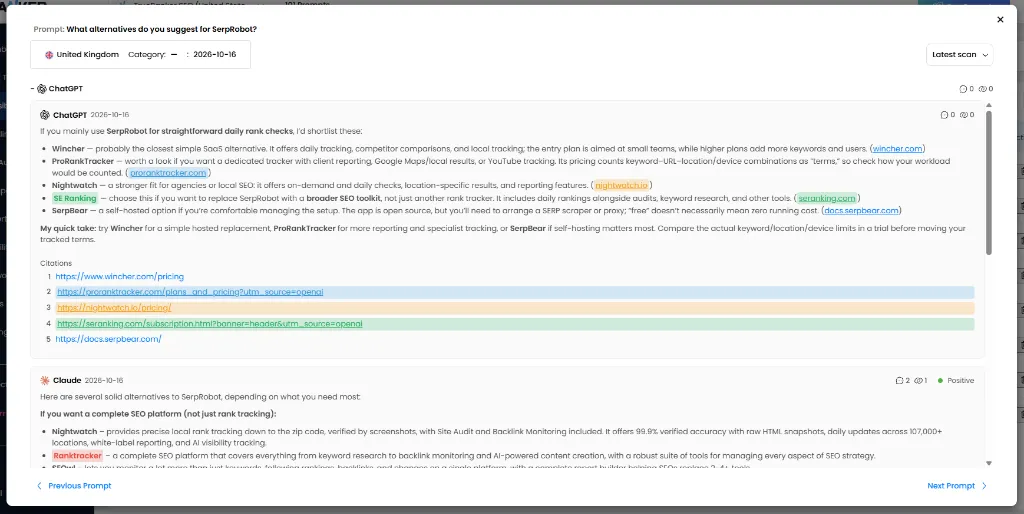
ChatGPT no se limitó a mencionar marcas en el texto; su motor de búsqueda web extrajo citas directas hacia páginas de tarifas. Fíjate en los enlaces que colocó al pie de la respuesta:
https://www.wincher.com/pricinghttps://proranktracker.com/plans_and_pricing?utm_source=openaihttps://nightwatch.io/pricing/https://seranking.com/subscription.html?banner=header&utm_source=openaihttps://docs.serpbear.com/
Dos de esas citas incorporan parámetros explícitos de rastreo utm_source=openai. Esto significa que el buscador de OpenAI rastreó esas páginas de precios, comprobó sus planes y presentó enlaces directos y clicables ante un usuario que buscaba sustituir a un proveedor actual.
Si únicamente monitorizas términos genéricos, pasarás por alto el punto exacto donde se toman las decisiones de contratación en las búsquedas conversacionales.
Consultas con factor de proximidad y transaccionales locales
Las consultas transaccionales con factor de proximidad responden a decisiones inmediatas donde la ubicación o la cobertura geográfica determinan la recomendación.
Suelen incorporar variables locales:
- “¿Cuáles son las agencias de SEO técnico mejor valoradas cerca de Valencia para tiendas online?”
- “¿Dónde puedo medir posiciones diarias en el Local Pack de Google para varias ciudades a la vez?”
Los asistentes de IA consultan fuentes web locales y bases de conocimiento geográficas para resolver estas peticiones. Para monitorizarlas con rigor, debes segmentar tus pruebas por país y ciudad para identificar las variaciones regionales de las citas.
Paso 3: Analiza las fuentes de recuperación en motores de IA conectados a la web
Analizar las fuentes de recuperación consiste en probar tus prompts candidatos en motores de IA con acceso a internet para descubrir qué medios, foros y directorios alimentan sus citas. Los modelos no se inventan los proveedores recomendados; extraen la información en vivo de un grupo concreto de publicaciones antes de redactar su respuesta.
Cuando plataformas como Perplexity, SearchGPT o Gemini responden a una consulta, muestran enlaces a pie de página o botones interactivos con sus referencias. Documentar esas fuentes te desvela el mapa de visibilidad de esa búsqueda:
- Prueba los prompts candidatos en motores conectados: Pasa tu lista inicial de 30 consultas por Perplexity, ChatGPT Search y Google AI Overviews.
- Registra los dominios citados de forma recurrente: Identifica si el buscador apoya su respuesta en análisis independientes, debates de Reddit, documentación oficial o artículos comparativos del sector.
- Detecta patrones de indexación: Si en cuatro de cada cinco pruebas el modelo cita artículos comparativos de blogs especializados o páginas de aterrizaje de producto, tu sitio web necesita páginas con una profundidad equivalente o presencia en esos medios de referencia.
- Descarta prompts que no activen búsqueda web: Si una consulta solo extrae información de la memoria interna del modelo sin buscar en la web, medir citas resultará inviable. Céntrate en prompts que desencadenen búsquedas externas de manera consistente.
Comprender esta mecánica de extracción es fundamental en los factores de ranking en búsqueda con IA, donde la relevancia de las fuentes consultadas condiciona qué marcas obtienen enlaces visibles.
Paso 4: Valida la consistencia de cada prompt con pruebas estadísticas
La validación estadística comprueba si un prompt ofrece visibilidad recurrente para tu marca mediante la ejecución de esa consulta entre 60 y 100 veces para calcular su probabilidad real de cita. Dado que los modelos generativos son probabilísticos, consultar un prompt una o dos veces ofrece una certeza nula.
En nuestros análisis internos, un prompt sin validar puede citar a una marca un martes por la mañana y omitirla completamente el miércoles por la tarde. Esta variación se debe a la temperatura del modelo, las variaciones de semilla y las actualizaciones constantes de los índices de búsqueda web.
Umbrales de fiabilidad estadística de un prompt:
  1 prueba manual:     ~10% a 20% de confianza estadística (Sin valor analítico)
  10 pruebas:          ~50% de confianza (Alta varianza)
  60 a 100 pruebas:    >95% de confianza (Línea base comercial fiable)
Durante esta fase de verificación debes diferenciar dos resultados complementarios:
- Tasa de mención de marca (Brand Mention Rate): Porcentaje de consultas donde el modelo escribe el nombre de tu empresa o producto dentro de su respuesta redactada.
- Tasa de cita de dominio (Domain Citation Rate): Porcentaje de ejecuciones donde el buscador incluye un enlace clicable hacia tu sitio web en sus fuentes a pie de respuesta.
Una mención de marca genera notoriedad pasiva, pero una cita de dominio canaliza tráfico directo y clientes cualificados hacia tu embudo de ventas. Si un prompt registra un 40% de mención pero un 0% de citas tras 80 pruebas, significa que el modelo reconoce tu entidad de marca, pero no encuentra ninguna URL con una estructura limpia y fácil de citar como fuente de datos.
¿Quieres automatizar estas pruebas sin perder horas de trabajo? Probar 100 consultas a mano en cinco plataformas de IA distintas consume un tiempo enorme y gasta saldo de API con rapidez. Puedes medir tu visibilidad conversacional y tus tasas de cita de forma automática con nuestra herramienta de visibilidad en IA, obteniendo métricas probabilísticas claras sin necesidad de programar scripts propios.
Paso 5: Agrupa por facetas semánticas y prepara tu contenido para la extracción de IA
Agrupar tus prompts validados en facetas informacionales y transaccionales te permite optimizar la estructura de tus páginas con bloques de respuesta directa para que los rastreadores de IA puedan extraer y citar tu contenido con facilidad. Una vez depurada tu lista de consultas, debes ordenarlas en grupos lógicos que orienten tu calendario de publicación.
Nosotros clasificamos los prompts en dos facetas operativas principales:
- Facetas informacionales: Preguntas sobre conceptos, comparativas de arquitectura técnica, resolución de problemas y guías metodológicas. Tienen su espacio natural en artículos de blog y centros de documentación.
- Facetas transaccionales: Consultas sobre precios, procesos de migración entre herramientas, equivalencia de funciones y alternativas comerciales. Deben resolverse en páginas de producto y landings comparativas dedicadas.
Para que los motores de recuperación puedan citar tus textos fácilmente (optimización por fragmentos o chunking), coloca una respuesta directa y completa de 1 a 2 frases justo debajo de cada encabezado H2 y H3. Evita introducciones vacías o rodeos retóricos. Cuando el rastreador de un LLM divide tu página en fragmentos semánticos, esa primera respuesta le entrega la cita exacta que necesita para respaldar su respuesta.
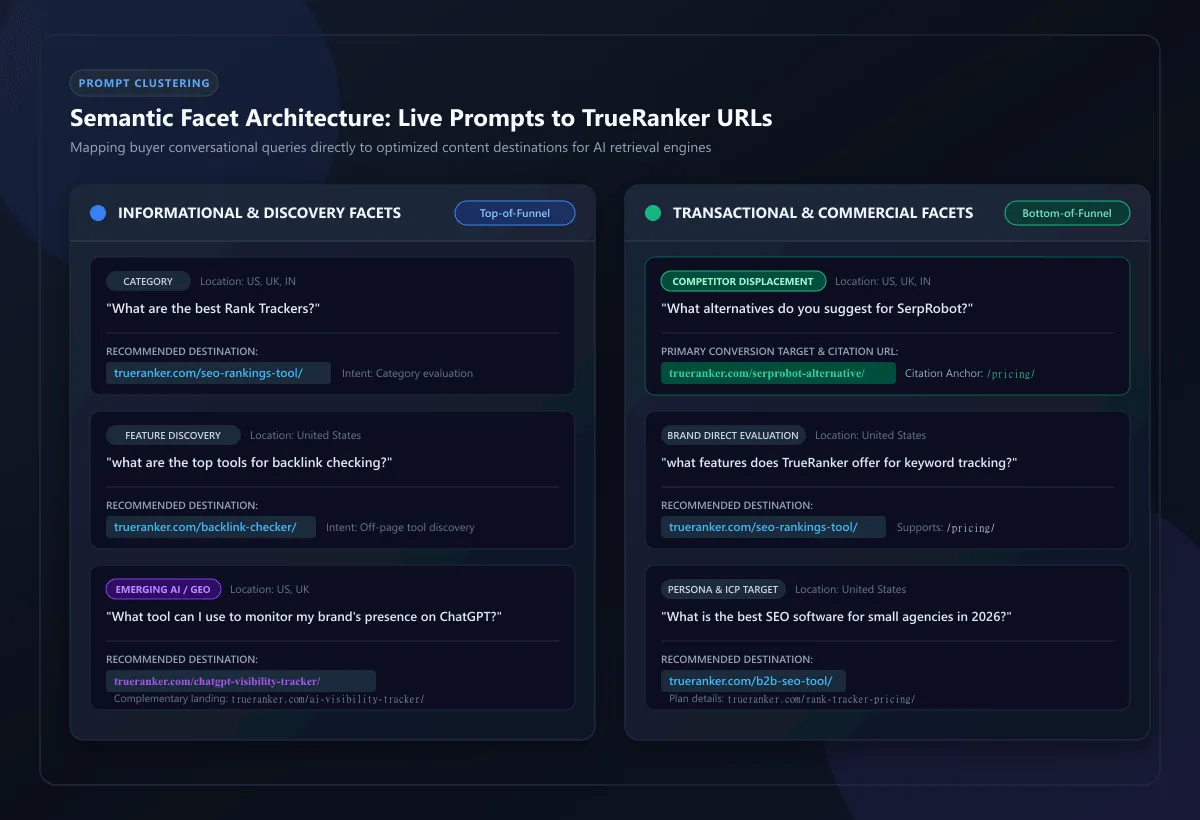
La tabla que tienes a continuación refleja cómo trasladamos cada prompt extraído de nuestro panel hacia su faceta de trabajo, su intención de compra y su página de destino recomendada dentro de TrueRanker:
| Prompt analizado | Faceta semántica | Intención de compra | URL recomendada en TrueRanker | Encabezado para extracción directa (Chunk) |
|---|---|---|---|---|
| “What alternatives do you suggest for SerpRobot?” | Transaccional | Desplazamiento de competidor (Bottom-of-Funnel) | /es/serprobot-alternativa/ y /es/planes/ |
Por qué TrueRanker es la alternativa directa más cercana a SerpRobot |
| “What are the best Rank Trackers?” | Informacional / Categoría | Evaluación general de mercado (Top-of-Funnel) | /es/herramienta-rankings-seo/ |
Qué características definen a un rank tracker moderno en 2026 |
| “what are the top tools for backlink checking?” | Informacional / Descubrimiento | Evaluación de funcionalidad complementaria | /es/monitor-backlinks/ |
Auditoría de enlaces entrantes en tiempo real sin costes enterprise |
| “what features does TrueRanker offer for keyword tracking?” | Transaccional | Evaluación directa de marca y funciones | /es/herramienta-rankings-seo/ |
Funcionalidades clave de seguimiento de palabras clave en TrueRanker |
| “What is the best SEO software for small agencies in 2026?” | Transaccional / Perfil de agencia | Decisión de compra B2B para equipos y agencias | /es/herramienta-seo-agencias/ |
Por qué las agencias eligen TrueRanker frente a herramientas con tarifas por usuario |
| “What tool can I use to monitor my brand’s presence on ChatGPT?” | Emergente IA / GEO | Monitorización de presencia de marca en IA | /es/rastreador-visibilidad-chatgpt/ |
Cómo monitorizar menciones y citas de marca en ChatGPT |
Cómo automatizar el descubrimiento y seguimiento de prompts sin scripts manuales
Automatizar el seguimiento de prompts mediante una plataforma especializada elimina la carga técnica de gestionar llamadas a APIs y programar scrapers con navegadores headless. Controlar decenas de prompts a mano en ChatGPT, Claude, Gemini y Perplexity resulta inasumible para cualquier agencia o empresa en crecimiento.
Crear un sistema de seguimiento interno exige configurar rotación de proxies residenciales, procesar respuestas en markdown sin formato estructurado, gestionar límites de peticiones y asumir facturas de tokens que se disparan al validar 100 ejecuciones por prompt. Además, las APIs de desarrollo no siempre replican el comportamiento real de los buscadores web de consumo como ChatGPT Search.
Por esta razón desarrollamos el rastreador de visibilidad en ChatGPT y el Índice de Visibilidad en IA dentro de TrueRanker (además del verificador de visibilidad en IA gratis para descubrir tus primeros prompts sin cuenta). En lugar de lidiar con hojas de cálculo manuales, la plataforma se encarga de todo el ciclo de trabajo:
- Sugerencias inteligentes de prompts: Detecta consultas conversacionales relevantes para tu sector a partir de patrones reales de búsqueda de los usuarios.
- Monitorización continua en varios modelos: Ejecuta rastreos periódicos en ChatGPT, Claude, Gemini, Copilot y Perplexity segmentados por países.
- Desglose de sentimiento y citas: Identifica si la percepción de tu marca es positiva, neutral o negativa, y te avisa cuando un competidor te arrebata una cita.
- Cálculo de cuota de voz (Share of Voice): Mide el porcentaje exacto de respuestas de tu sector donde tu marca aparece recomendada frente a tus rivales directos.
Puedes consultar nuestros límites de monitorización y opciones disponibles en nuestra página de planes y tarifas, con la flexibilidad de adaptar el servicio a tus necesidades sin permanencias forzosas.
Preguntas frecuentes
¿Cuántos prompts conviene monitorizar al principio?
Conviene empezar con un bloque de 20 a 40 prompts repartidos a partes iguales entre comparativas comerciales y preguntas sobre problemas concretos. Mantener una lista inicial acotada evita dispersar el presupuesto y permite consolidar una línea base clara de citas antes de explorar variantes más específicas.
¿Tiene sentido rastrear prompts si cada usuario pregunta a ChatGPT de forma distinta?
Sí, porque los modelos de lenguaje agrupan miles de formulaciones distintas bajo los mismos conceptos semánticos y tareas de recuperación. No necesitas monitorizar cada frase exacta; controlar el prompt principal te permite evaluar cómo responde el modelo a toda esa intención de búsqueda.
¿Qué diferencia hay entre una mención de marca y una cita en buscadores de IA?
Una mención de marca se produce cuando el motor escribe el nombre de tu producto en el texto de su respuesta, mientras que una cita incluye un enlace activo y clicable hacia tu dominio entre las fuentes de referencia. Las citas son las que canalizan tráfico cualificado y demuestran que el modelo utilizó tu página para respaldar su respuesta.
¿Cada cuánto tiempo conviene revisar y renovar la lista de prompts?
Lo ideal es auditar la lista de prompts cada 30 o 60 días para retirar las consultas que no activen búsqueda en la web y añadir las nuevas preguntas que tus clientes trasladen al equipo comercial. A medida que los motores de IA actualizan sus índices y tus competidores publican nuevo contenido, las preguntas de los usuarios evolucionan de manera natural.
Descubre qué dicen los asistentes de IA sobre tu marca
TrueRanker identifica las preguntas reales de tus compradores y monitoriza tus menciones y citas en ChatGPT, Perplexity, Claude y Gemini automáticamente.
Escrito por
Javier Quevedo
Cofundador y CEO, Lead SEO
Javier cofundó TrueRanker y lidera el frontend, la web pública y el último tramo entre un ranking en la base de datos y la pantalla que usa un SEO. Lleva años convirtiendo GEO, SEO local, on-page y visibilidad en IA en producto — y en las guías de este blog — para que las agencias midan las citas de ChatGPT igual que ya miden Google. También trabaja el backend: una interfaz limpia sobre datos viejos sigue siendo una mentira.
Te puede interesar
Qué es llms.txt: lo que dicen los datos y si de verdad lo necesitas
Qué es llms.txt, qué dicen tres estudios sobre su impacto en citas de IA y cuándo tiene sentido añadirlo. Sin hype, solo datos.
Javier Quevedo13 min de lectura
Leer el artículoLa checklist de optimización IA que aplico antes de hacer cambios en una página.
Con esta checklist de optimización IA coges un prompt, miras si te citan o te nombran y compruebas si editar la página sirvió de algo.
Javier Quevedo10 min de lectura
Leer el artículoLos factores de ranking en búsquedas con IA solo cuentan si consigues que te citen.
Si una página sale citada en ChatGPT o Perplexity y otra no, la causa son los factores de ranking en búsquedas con IA. Te cuento qué miro en un prompt.
Javier Quevedo14 min de lectura
Leer el artículoPor qué tu posición en Google no dice nada de tu visibilidad en IA
Ser el #3 en Google no te mete en la respuesta de ChatGPT. Por qué se han separado y qué medir en su lugar.
TrueRanker2 min de lectura
Leer el artículo¿Qué es el Monitoreo de Marca en IA? (Y por qué es crucial en 2026)
Qué es el monitoreo de marca en IA, en qué se diferencia del SEO y cómo medir menciones, citas y share of voice.
Javier Quevedo7 min de lectura
Leer el artículoShare of Voice en IA: Cómo saber si ChatGPT recomienda a tu competencia [2026]
Mide tu share of voice en ChatGPT y Gemini frente a rivales y lee qué dicen los LLMs de tu marca.
Javier Quevedo5 min de lectura
Leer el artículo