Hoe je de juiste prompts vindt en kiest voor je AI-zichtbaarheid
Zo kies je prompts voor AI-zichtbaarheid: van buyer persona-simulaties tot 100 testruns. Ontdek welke prompts echte citaties opleveren in ChatGPT.

Je kent de frustratie vast wel: je opent ChatGPT, vraagt naar de beste software binnen jouw niche en ziet hoe het model drie van je directe concurrenten aanbeveelt terwijl jouw merk nergens wordt genoemd. Je stelt dezelfde vraag een minuut later opnieuw en het antwoord verandert. Je test het de volgende dag nog eens en de aangehaalde bronnen zijn alweer gewisseld.
Als je het volgen van prompts in AI benadert zoals traditionele zoekwoordmonitoring, ben je wekenlang bezig met het verzamelen van onbruikbare data. Grote taalmodellen werken niet met vaste maandelijkse zoekvolumes en tonen geen statisch overzicht van tien blauwe links. Het zijn probabilistische systemen die elk antwoord real-time synthetiseren op basis van live webzoekopdrachten, semantische vectoren en hun eigen interne redeneervermogen.
Om een strategie voor AI-zichtbaarheid op te bouwen die daadwerkelijk bijdraagt aan je bedrijfsresultaten, moet je achterhalen welke concrete conversationele vragen echte kopers stellen, hoe consistent de antwoorden zijn en welke prompts directe citaties naar jouw website opleveren. Hieronder vind je het stappenplan in vijf fasen dat wij gebruiken om de juiste prompts voor AI-zoekmachines te ontdekken, te valideren en te monitoren.
Waarom het tracken van prompts geen zoekwoordonderzoek in een nieuw jasje is
Het volgen van prompts verschilt fundamenteel van klassiek zoekwoordonderzoek omdat conversationele zoekopdrachten leiden tot meervoudige zoekdecompositie en probabilistische synthese, in plaats van een directe match met een vaste database-index. De AI-zoekmachine analyseert de finesses van de gebruikersvraag, voert live zoekopdrachten uit op het web, beoordeelt de gevonden tekstfragmenten en formuleert telkens een nieuw, op maat gemaakt antwoord.
Wanneer iemand beste rank tracker intypt in Google, toetst de zoekmachine die term aan een geïnverteerde index. Vrijwel elke bezoeker op dezelfde locatie krijgt nagenoeg dezelfde resultaten te zien. Maar wanneer een potentiële koper aan ChatGPT of Perplexity om software-advies vraagt, interpreteert het model specifieke randvoorwaarden, raadpleegt het actuele webbronnen en stelt het een gepersonaliseerde vergelijking op.
Drie doorslaggevende verschillen scheiden prompt-onderzoek van klassieke SEO:
- Afwezigheid van een vast maandelijks zoekvolume: Traditionele SEO-tools vertellen je dat een zoekwoord 2.400 maandelijkse zoekopdrachten heeft. Prompts kennen die statistiek niet omdat menselijke dialogen oneindig veel semantische variaties kennen. Je monitort intentie-clusters en zoekbehoeften, geen exacte woordcombinaties.
- Contextuele verdieping en meervoudige zoekopdrachten (query fan-out): Een vraag zoals «Welke alternatieven raad je aan voor SerpRobot voor een bureau met 50 lokale klanten?» dwingt het taalmodel om op de achtergrond meerdere zoekopdrachten tegelijk uit te voeren (tariefvergelijkingen, ondersteuning voor meerdere locaties of geautomatiseerde klantrapportages).
- Probabilistische verschuiving van citaties: In traditionele zoekresultaten blijft een URL op positie 3 vaak dagen of weken stabiel. Bij taalmodellen kan een merk dat in run 1 prominent wordt genoemd, in run 3 volledig ontbreken als de prompt niet over herhaalde runs statistisch gevalideerd is.
| Beoordelingscriterium | Klassieke zoekwoordmonitoring | Prompt-monitoring voor LLM’s |
|---|---|---|
| Zoekvolume | Vaste maandelijkse schattingen (Ahrefs, GSC) | Geen vast volume; clusters van conversationele intenties |
| Outputformaat | Geordende lijst met blauwe links (1 tot 10) | Samengestelde tekst, vergelijkingspunten en citatielinks |
| Stabiliteit | Relatief stabiele dagelijkse posities | Probabilistisch; antwoorden en bronnen variëren per run |
| Conversiewaarde | Organische positie op de eerste pagina | Prominente vermelding en directe citatielink naar de site |
| Zoekmechanisme | Enkelvoudige query op een zoekmachine-index | Vraagdecompositie, live webextractie en synthese |
| Hoofddoel | Organische klikken verzamelen vanuit de SERP | Merkaanbevelingen winnen en domeincitaties bemachtigen |
Stap 1: Bepaal de operationele context van je project en het koperprofiel
Voordat je een taalmodel om prompt-ideeën vraagt, moet je het voorzien van een scherp omlijnd operationeel kader: je ideale koperprofiel, je kernaanbod, veelvoorkomende bezwaren en het daadwerkelijke taalgebruik van je klanten. Als je zonder deze context vragen stelt aan een AI, krijg je louter generieke lijstjes terug die echte kopers nooit zouden intypen.
Bij de audits die ik uitvoer voor SaaS-oprichters en marketingteams begin ik altijd met het doornemen van verkoopgesprekken, supporttickets en notities in het CRM. Echte klanten stellen zelden encyclopedische vragen zoals «Wat is SEO-software?». Ze leggen heel gerichte situaties voor die voortkomen uit hun dagelijkse knelpunten:
- Sector en teamgrootte: Een zelfstandige consultant zoekt anders dan de lead van een online marketingbureau met 20 specialisten.
- Fricties en knelpunten: Hoge kosten per gebruiker, forse tariefsprongen bij uitbreiding, gebrekkige tracking in Google Maps of trage positie-updates.
- Terugkerende bezwaren: «Waarom zou ik hiervoor betalen als ik Google Search Console al heb?» of «Hoe exporteer ik deze data eenvoudig naar mijn maandrapportages?».
- Onmisbare functionaliteiten: White-label rapportages voor klanten, lokale tracking tot op postcodeniveau of multi-model monitoring in AI.
Voer deze context in bij je modelsessie voordat je begint met simuleren. Zodra het model begrijpt binnen welke kaders jouw markt beweegt, sluiten de gegenereerde vragen naadloos aan op daadwerkelijke aankoopgesprekken.
Stap 2: Pas reverse engineering toe op de koopintentie via simulaties
Reverse engineering van de koopintentie houdt in dat je geavanceerde redeneermodellen vraagt om in de huid van je ideale klant te kruipen en diens vragen tijdens het besluitvormingsproces na te bootsen. In plaats van te gokken wat iemand zou typen, laat je het model het denkproces doorlopen: van het eerste probleem tot de uiteindelijke leveranciersvergelijking.
Voor dit onderdeel gebruik ik modellen met diepgaand redeneervermogen (zoals OpenAI o3, Claude 3.7 Sonnet of Gemini 2.0 Pro) met een gedetailleerde simulatie-opdracht:
«Verplaats je in de rol van SEO-verantwoordelijke bij een gespecialiseerd bureau dat 30 lokale klanten beheert. Je stoort je aan tools met torenhoge licenties per gebruiker en verouderde platformen die geen rekening houden met AI-zoekopdrachten. Schrijf 15 concrete, conversationele vragen op die je aan ChatGPT of Perplexity zou stellen om een modernere tool te vinden, te vergelijken en intern te verantwoorden.»
Uit zo’n simulatie komen prompts naar voren die zich verdelen over drie heldere commerciële fasen:
Prompts gericht op symptomen en pijnpunten
Pijnpunt-prompts vangen de gebruiker op het moment dat deze tegen een technisch probleem aanloopt of een daling in resultaten opmerkt en een AI-assistent raadpleegt om de oorzaak te achterhalen.
Ze beginnen vaak met een rechtstreekse probleembeschrijving:
- «Waarom toont Google Search Console andere zoekwoordposities dan externe rank tracking software?»
- «Waarom daalt mijn organisch verkeer terwijl mijn rankings in Google stabiel blijven?»
- «Hoe controleer ik of ChatGPT mijn concurrenten citeert in plaats van mijn eigen domein?»
Een citatie in deze antwoorden positioneert je als inhoudelijk expert nog voordat de koper specifieke merken begint te vergelijken.
Commerciële en vergelijkende prompts tussen concurrenten
Commerciële en vergelijkende prompts ontstaan wanneer een potentiële koper alternatieven tegen elkaar afweegt en het model vraagt om specifieke tools te vergelijken.
Deze vragen vertegenwoordigen de hoogste conversiekansen:
- «Wat is de beste SEO-tool voor kleine bureaus in 2026?»
- «Welke alternatieven raad je aan voor SerpRobot?»
- «Wincher vs ProRankTracker vs TrueRanker: welke werkt het best voor lokale positiebewaking?»
Hieronder zie je een praktijkvoorbeeld uit ons eigen dashboard dat aantoont waarom vergelijkende zoekvragen vele malen waardevoller zijn dan algemene categorievragen.
Toen we vorige week de trackingdata bekeken voor onze scans in de Verenigde Staten, het Verenigd Koninkrijk en India, viel direct een scherp contrast op tussen twee typen prompts:
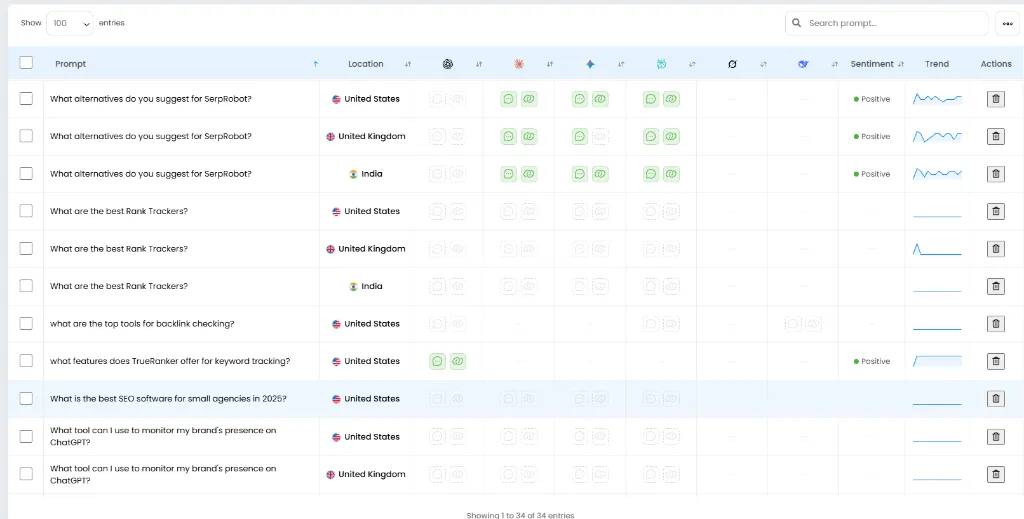
Bij brede categorievragen zoals «What are the best Rank Trackers?» veranderde de zichtbaarheid nauwelijks tussen de modellen. De reden? Algemene vragen leveren samenvattingen op die steunen op affiliate-artikelen die al jaren op het web circuleren.
Bij de concurrentie-vervangende prompt bovenaan de lijst («What alternatives do you suggest for SerpRobot?») was het beeld totaal anders: het sentiment was uitgesproken positief en er waren geverifieerde groene citaties te zien in Claude, Gemini en Copilot.
Bij het openen van de ChatGPT-scan voor die zoekvraag in het Verenigd Koninkrijk werd het effect pas echt duidelijk:
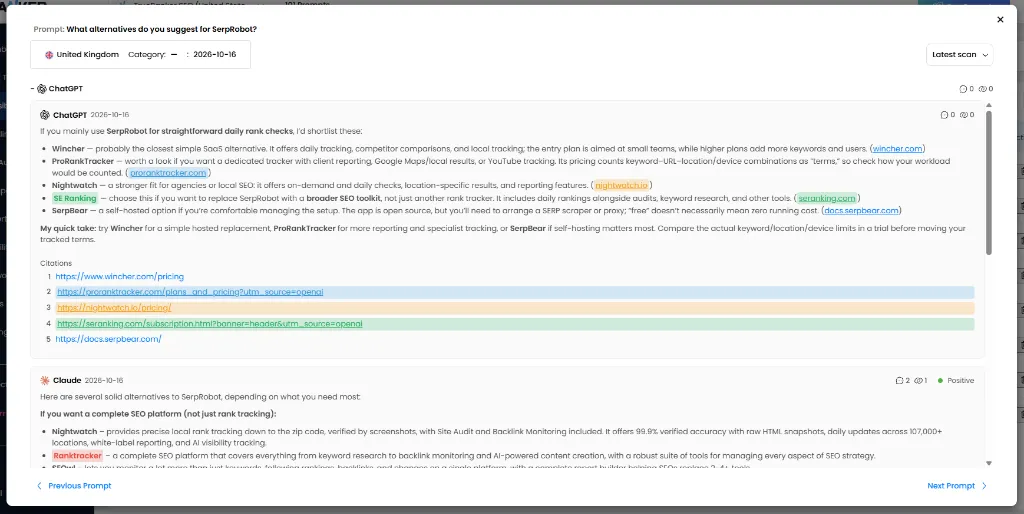
ChatGPT bleef niet hangen in het noemen van merknamen in de tekst; de ingebouwde zoekmachine voegde directe citatielinks toe naar tarievenpagina’s. Bekijk de links onderaan het antwoord:
https://www.wincher.com/pricinghttps://proranktracker.com/plans_and_pricing?utm_source=openaihttps://nightwatch.io/pricing/https://seranking.com/subscription.html?banner=header&utm_source=openaihttps://docs.serpbear.com/
Twee van die citaties bevatten expliciete trackingparameters: utm_source=openai. Dit bewijst dat de zoekmachine van OpenAI die prijspagina’s heeft gecrawld, de abonnementsvormen heeft geanalyseerd en klikbare links heeft voorgeschoteld aan een gebruiker die actief zocht naar een alternatief.
Als je uitsluitend algemene termen monitort, mis je exact de plek waar aankoopbeslissingen in conversationele zoekmachines worden genomen.
Vragen met een lokale factor en directe aankoopintentie
Lokale transactievragen hebben betrekking op directe beslissingen waarbij locatie of geografische dekking bepalend is voor het advies.
Ze bevatten doorgaans geografische filters:
- «Wat zijn de best beoordeelde technische SEO-bureaus in Amsterdam voor webshops?»
- «Met welke software kan ik dagelijks Google Local Pack-posities volgen voor meerdere steden tegelijk?»
AI-assistenten raadplegen lokale webbronnen en geografische databases om deze vragen te beantwoorden. Om dit betrouwbaar te monitoren, moet je je tests segmenteren op land en stad om regionale variaties in citaties in kaart te brengen.
Stap 3: Analyseer de extractiebronnen van AI-zoekmachines met internettoegang
Het analyseren van extractiebronnen houdt in dat je je kandidaat-prompts test in AI-zoekmachines met live internettoegang om te ontdekken welke platforms, vakmedia en fora hun citaties voeden. Taalmodellen verzinnen aanbevolen tools niet zelf; ze halen hun gegevens in real-time op bij een selecte groep publicaties voordat ze hun antwoord opstellen.
Wanneer platforms zoals Perplexity, SearchGPT of Gemini een vraag beantwoorden, tonen ze bronverwijzingen in voetnoten of interactieve knoppen. Door die bronnen systematisch vast te leggen, breng je het zichtbaarheidslandschap van die zoekvraag in kaart:
- Test je geselecteerde prompts in aangesloten zoekmachines: Voer je initiële lijst van 30 vragen in bij Perplexity, ChatGPT Search en Google AI Overviews.
- Breng herhaaldelijk geciteerde domeinen in kaart: Controleer of het model steunt op onafhankelijke reviews, discussies op Reddit, officiële documentatie of vergelijkende artikelen op vakblogs.
- Herken indexatiepatronen: Als het model in vier van de vijf tests vergelijkingsartikelen van experts of productlandingspagina’s citeert, moet jouw website vergelijkbare diepgaande content bieden of op die toonaangevende platforms aanwezig zijn.
- Schrap prompts zonder webzoekactie: Als een vraag louter beantwoord wordt vanuit het interne geheugen van het model zonder externe zoekactie, is het meten van URL-citaties onmogelijk. Focus op prompts die consistent een live zoekactie triggeren.
Inzicht in dit extractiemechanisme is essentieel voor je AI-zichtbaarheid, aangezien de autoriteit en structuur van de geraadpleegde bronnen bepalen welke domeinen zichtbare links verdienen.
Stap 4: Valideer de consistentie van elke prompt via statistische runs
Statistische validatie toetst of een prompt structureel zichtbaarheid oplevert voor jouw merk door de vraag 60 tot 100 keer uit te voeren en zo de werkelijke citatiekans te berekenen. Omdat generatieve modellen probabilistisch werken, biedt een prompt één of twee keer testen geen enkele zekerheid.
Uit onze interne metingen blijkt dat een niet-gevalideerde prompt een merk op dinsdagochtend kan aanbevelen en op woensdagmiddag compleet kan negeren. Die schommelingen ontstaan door modeltemperatuur, variaties in de random seed en doorlopende updates in de zoekmachine-indices.
Betrouwbaarheidsdrempels van een prompt:
  1 handmatige test:   ~10% tot 20% betrouwbaarheid (Geen analytische waarde)
  10 tests:            ~50% betrouwbaarheid (Hoge variantie)
  60 tot 100 tests:    >95% betrouwbaarheid (Solide commerciële nulmeting)
Tijdens deze fase moet je twee afzonderlijke statistieken uit elkaar houden:
- Merkvermeldingspercentage (Brand Mention Rate): Het percentage runs waarin het model de naam van je bedrijf of product noemt in de gegenereerde tekst.
- Domeincitatiepercentage (Domain Citation Rate): Het percentage runs waarin de zoekmachine een klikbare link naar jouw website toevoegt aan de bronvermeldingen.
Een merkvermelding bouwt passieve naamsbekendheid op, maar alleen een domeincitatie stuurt gekwalificeerd verkeer rechtstreeks naar je conversie-funnel. Als een prompt na 80 runs een vermeldingspercentage van 40% heeft maar 0% citaties, weet het model wel wie je bent, maar vindt het geen helder gestructureerde URL die geschikt is als feitelijke bron.
Wil je deze tests automatiseren zonder handmatige rompslomp? Honderd vragen handmatig invoeren over vijf verschillende AI-modellen kost enorm veel tijd en slurpt API-credits. Je kunt je conversationele zichtbaarheid en citatiepercentages geautomatiseerd volgen met onze module voor AI-zichtbaarheid, waarmee je direct inzicht krijgt in probabilistische data zonder zelf scripts te hoeven onderhouden.
Stap 5: Cluster op semantische facetten en structureer je content voor AI-extractie
Door je gevalideerde prompts onder te verdelen in informatieve en transactionele facetten kun je de paginastructuur van je website optimaliseren met directe antwoordblokken, zodat AI-crawlers je content snel kunnen extraheren en citeren. Zodra je lijst met zoekvragen is opgeschoond, rangschik je ze in logische groepen voor je contentplanning.
Wij splitsen prompts op in twee operationele hoofdcategorieën:
- Informatieve facetten: Vragen over concepten, technische architecturen, probleemoplossing en methodologische gidsen. Deze horen thuis op een blog of in een kennisbank.
- Transactionele facetten: Vragen over prijzen, migraties tussen software, functievergelijkingen en alternatieven. Deze moeten beantwoord worden op productpagina’s en specifieke vergelijkingslandingspagina’s.
Om ervoor te zorgen dat AI-modellen je teksten moeiteloos kunnen citeren (chunking-optimalisatie), plaats je een direct en compleet antwoord van 1 tot 2 zinnen direct onder elke H2- en H3-tussenkop. Vermijd wollige inleidingen of retorische omwegen. Wanneer de crawler van een LLM je pagina opdeelt in semantische fragmenten, biedt die eerste alinea exact het citaatbare feit dat nodig is om de vraag te beantwoorden.
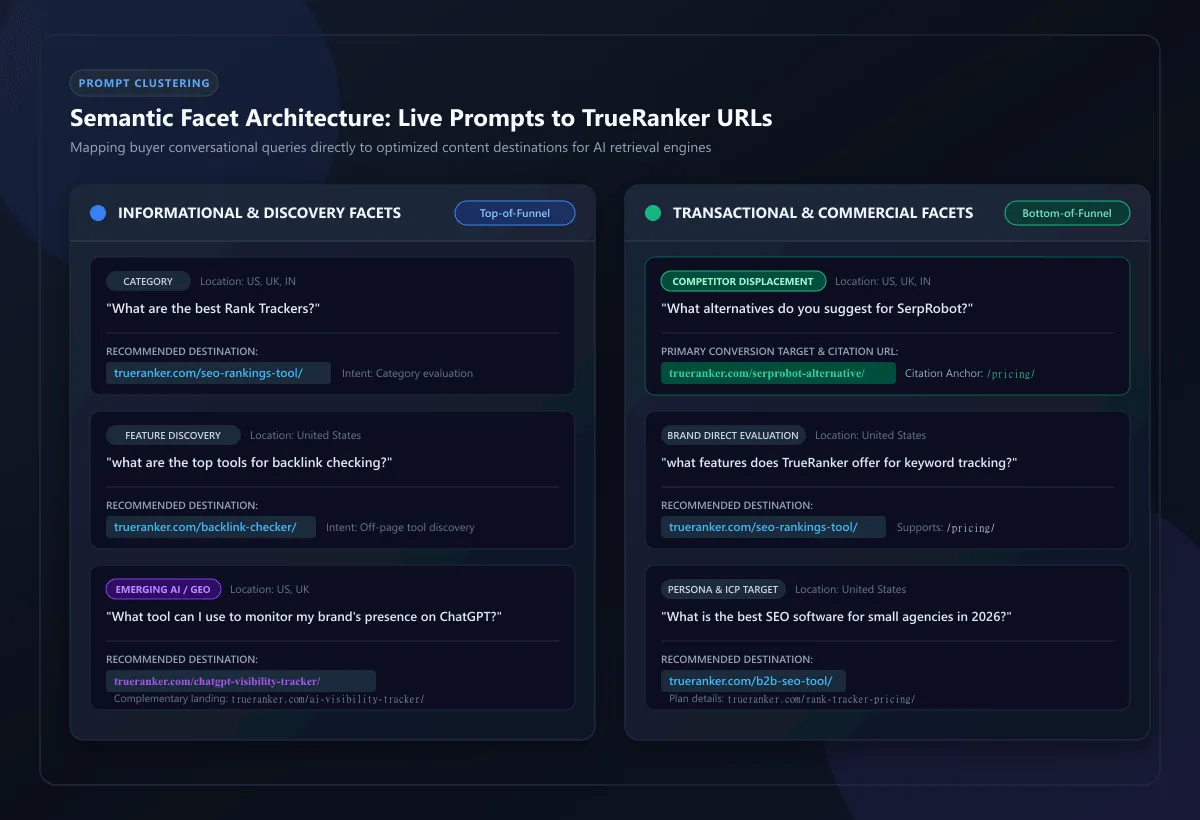
In het onderstaande overzicht zie je hoe wij concrete prompts uit onze dashboards koppelen aan hun facet, koopintentie en de bijbehorende bestemmingspagina binnen TrueRanker:
| Geanalyseerde prompt | Semantisch facet | Koopintentie | Aanbevolen URL op TrueRanker | Tussenkop voor directe extractie (Chunk) |
|---|---|---|---|---|
| «What alternatives do you suggest for SerpRobot?» | Transactioneel | Concurrent vervangen (Bottom-of-Funnel) | /nl/alternatief-voor-serprobot/ & /nl/prijzen/ |
Waarom TrueRanker het meest directe alternatief voor SerpRobot is |
| «What are the best Rank Trackers?» | Informatief / Categorie | Algemene marktoriëntatie (Top-of-Funnel) | /nl/ranking-tool/ |
Welke eigenschappen een moderne rank tracker definieert in 2026 |
| «what are the top tools for backlink checking?» | Informatief / Ontdekking | Oriëntatie op aanvullende functies | /nl/backlink-monitor/ |
Real-time backlinkmonitoring zonder enterprise-kosten |
| «what features does TrueRanker offer for keyword tracking?» | Transactioneel | Directe merk- en functionaliteitscontrole | /nl/ranking-tool/ |
Belangrijkste functies voor zoekwoordmonitoring in TrueRanker |
| «What is the best SEO software for small agencies in 2026?» | Transactioneel / Bureauprofiel | B2B-aankoopkeuze voor bureaus en teams | /nl/seo-tool-bureaus/ |
Waarom marketingbureaus kiezen voor TrueRanker in plaats van tools met licenties per gebruiker |
| «What tool can I use to monitor my brand’s presence on ChatGPT?» | Opkomend AI / GEO | Merkmonitoring en citatiebewaking in AI | /nl/chatgpt-zichtbaarheid/ |
Hoe je vermeldingen en citaties van je merk monitort in ChatGPT |
Prompt-monitoring automatiseren zonder handmatige scripts
Het automatiseren van je prompt-monitoring via een gespecialiseerd platform neemt de technische complexiteit van API-koppelingen en het bouwen van scrapers met headless browsers volledig weg. Tientallen prompts handmatig controleren in ChatGPT, Claude, Gemini en Perplexity is simpelweg ondoenlijk voor een groeiend bureau of bedrijf.
Een eigen systeem bouwen vereist het opzetten van roterende residentiële proxy’s, het parsen van ongestructureerde markdown-teksten, het omgaan met rate limits en torenhoge API-facturen die snel oplopen bij 100 runs per prompt. Bovendien weerspiegelen developer-API’s niet altijd het daadwerkelijke zoekgedrag van consumenteninterfaces zoals ChatGPT Search.
Daarom hebben we ChatGPT-zichtbaarheid geïntegreerd in TrueRanker. In plaats van te worstelen met spreadsheets, verzorgt het platform het complete proces:
- Relevante promptsuggesties: Ontdekking van conversationele zoekvragen die aansluiten op jouw markt op basis van reëel zoekgedrag.
- Continue multi-model monitoring: Periodieke runs over ChatGPT, Claude, Gemini, Copilot en Perplexity, gesegmenteerd per land.
- Sentiment- en citatieanalyse: Inzicht in de toonsoort (positief, neutraal of negatief) en alerts wanneer een concurrent een citatielink overneemt.
- Berekening van Share of Voice: De exacte berekening van het percentage antwoorden binnen jouw branche waarin jouw merk wordt aangeraden ten opzichte van concurrenten.
Bekijk onze monitoringlimieten en abonnementsvormen op onze prijzenpagina, flexibel aan te passen aan jouw wensen zonder langdurige contracten.
Veelgestelde vragen
Met hoeveel prompts kan ik het best beginnen?
Het is verstandig om te starten met een set van 20 tot 40 prompts, gelijkmatig verdeeld over vergelijkende commerciële vragen en specifieke probleemgerichte zoekopdrachten. Zo houd je overzicht, voorkom je budgetverspilling en bouw je eerst een betrouwbare nulmeting op voordat je de lijst uitbreidt.
Heeft prompt-tracking wel zin als elke gebruiker een andere vraag stelt aan ChatGPT?
Jazeker, omdat grote taalmodellen duizenden verschillende formuleringen herleiden naar dezelfde semantische concepten en extractietaken. Je hoeft niet elke afzonderlijke zin te volgen; door de centrale prompt te monitoren zie je precies hoe het model omgaat met die overkoepelende zoekintentie.
Wat is het verschil tussen een merkvermelding en een citatie in AI-zoekmachines?
Een merkvermelding ontstaat wanneer de AI de naam van je bedrijf of product noemt in het gegenereerde antwoord. Een citatie bevat daarentegen een klikbare link naar jouw domein in de bronverwijzingen. Citaties sturen daadwerkelijk bezoekers door en tonen aan dat het model jouw pagina heeft geraadpleegd om het antwoord te onderbouwen.
Hoe vaak moet ik mijn lijst met prompts herzien?
Het is raadzaam om je selectie elke 30 tot 60 dagen door te lichten. Zo verwijder je vragen die geen live zoekacties meer triggeren en voeg je nieuwe vragen toe die je salesteam opvangt bij klanten. Naarmate AI-zoekmachines hun indexen vernieuwen en concurrenten nieuwe content publiceren, veranderen de zoekvragen van gebruikers op natuurlijke wijze mee.
Ontdek wat AI-zoekmachines over jouw merk zeggen
TrueRanker identificeert de echte vragen van je doelgroep en monitort je vermeldingen en citaties in ChatGPT, Perplexity, Claude en Gemini automatisch.
Geschreven door
Javier Quevedo
Medeoprichter en CEO, Lead SEO
Javier medeoprichtte TrueRanker en leidt de frontend, de publieke site en het laatste stuk tussen een ranking in de database en het scherm dat een SEO echt gebruikt. Al jaren zet hij GEO, lokale SEO, on-page en AI-zichtbaarheid om in product — en in de gidsen op deze blog — zodat bureaus citaties in ChatGPT meten zoals ze Google al meten. Hij werkt ook aan de backend: een nette interface op oude data blijft een leugen.