Qu’est-ce que l’ingénierie de contenu ? Mon framework pour le SEO et le GEO
L’ingénierie de contenu structure chaque URL pour répondre à l’intention et être citée par l’IA. Découvrez comment créer des sections claires et directes.

De nombreuses équipes continuent de traiter un article de blog comme une longue dissertation de deux mille mots avec un mot-clé placé dans le titre. Cette méthode fonctionnait lorsqu’il s’agissait simplement de positionner un document parmi dix liens bleus. Elle montre aujourd’hui ses limites quand ChatGPT, Perplexity, Gemini ou les AI Overviews de Google sélectionnent un court extrait de texte pour composer une réponse directe.
L’ingénierie de contenu est ma méthode pour structurer chaque page afin de remplir ces deux missions : se positionner sur l’intention de recherche et rester citable lorsqu’un modèle d’IA découpe le HTML. Je la compare d’abord au marketing de contenu, puis je vous détaille le framework que j’applique pour le SEO et l’optimisation pour les moteurs génératifs (GEO).
En quoi consiste réellement l’ingénierie de contenu
L’ingénierie de contenu est la discipline technique et analytique qui consiste à concevoir et structurer chaque URL pour répondre à une intention de recherche précise, tout en facilitant son traitement par Google et par les modèles d’IA générative.
L’unité de travail n’est pas de rédiger deux mille mots au kilomètre. C’est une URL pour une intention, avec des sous-titres qui traitent les questions secondaires, des sections qui conservent leur clarté lorsqu’elles sont citées isolément et des affirmations vérifiables avec des sources primaires. Un ingénieur de contenu décide de l’architecture de la page avant même d’écrire la première phrase : la même rigueur qu’un brief SEO appuyé sur les données, avec une exigence indispensable en plus : l’extractibilité.
J’applique cette approche lorsque la demande est purement informationnelle et que la SERP récompense la profondeur technique : définitions, guides pratiques, comparatifs. Je ne l’utilise pas comme un prétexte pour publier à la chaîne des brouillons d’IA non relus. Produire du volume sans architecture ne sert qu’à accumuler des pages qui ne se positionnent nulle part et que personne ne cite.
Ingénierie de contenu vs marketing de contenu
Le marketing de contenu pilote la ligne éditoriale, le récit de marque et le calendrier de publication. L’ingénierie de contenu conçoit l’architecture technique de chaque URL pour que les moteurs et les modèles d’IA puissent exploiter cette histoire.
| Marketing de contenu | Ingénierie de contenu | |
|---|---|---|
| Objectif principal | Attirer et convaincre une audience | Répondre à une intention avec une structure extractible |
| Unité de travail | Campagne, thématique, pilier de contenu | Une URL, un H1 et des blocs hiérarchisés H2 et H3 |
| Signal de succès | Engagement, pipeline, notoriété de marque | Positions, snippets, mentions et citations |
| Risque habituel | De beaux textes qui ne se positionnent jamais | Des modèles rigides qui rankent sans rien apporter de neuf |
Le jugement marketing reste indispensable. Faire de l’ingénierie sans comprendre son audience ni défendre une thèse revient à monter un échafaudage vide. Mais faire du marketing sans structure produit des murs de texte que les modèles de langage ignorent purement et simplement.
Quand on me demande de comparer ingénierie de contenu et marketing de contenu, je montre toujours ce tableau : la voix de la marque reste identique, mais le rôle joué sur la page est complètement différent.
Pourquoi le SEO classique reste la porte d’entrée du GEO
Si votre page ne figure pas parmi les documents retenus lors de la recherche traditionnelle, les moteurs génératifs ne la retiendront pratiquement jamais comme source pour la citer. Le SEO classique reste la porte d’entrée indispensable.
Les systèmes de recherche d’information et les moteurs de réponse ont tous deux besoin d’un document préalable qu’ils peuvent trouver, valider et citer. L’optimisation pour les moteurs génératifs (GEO) ajoute une seconde couche axée sur le découpage en blocs, la synthèse et l’attribution, mais elle ne remplace ni la pertinence ni l’autorité de domaine. J’ai vu trop d’équipes peaufiner des textes pour l’IA sur des URL qui n’apparaissaient même pas dans les premiers résultats du sujet. Le modèle n’avait tout simplement aucune matière à extraire.
C’est pourquoi je commence toujours par verrouiller l’intention de recherche, la couverture du sujet dans la SERP et la clarté on-page avant de parler de prompts ou d’AI Overviews.
Les SERP déterministes de Google face aux réponses probabilistes des LLM
Le SEO traditionnel évalue des documents entiers pour construire une liste ordonnée par positions. Le GEO sélectionne des documents pertinents, puis laisse un LLM formuler une réponse synthétique à partir d’extraits sous une part d’incertitude.
| Étape | SEO classique (liste déterministe) | GEO / LLMO (réponse probabiliste) |
|---|---|---|
| Entrée | Requête → documents | Requête → documents → extraits textuels |
| Décision | Pertinence + autorité → SERP ordonnée | Raisonnement sur les fragments → réponse synthétique |
| Ce qu’est la réussite | Position élevée et clic | Mention, recommandation ou citation dans la réponse |
| Mode d’échec | Page deux et aucun trafic | Document consulté par l’IA mais jamais cité |
Créer du contenu structuré pour l’IA implique de rédiger pour satisfaire les deux colonnes : le document complet doit se positionner, et chaque section doit pouvoir survivre seule en tant que bloc autonome. C’est cela, la réalité d’une architecture sémantique : des entités clairement identifiées, des phrases nettes construites en sujet-verbe-complément et des titres qui énoncent précisément la question à laquelle ils répondent.
Mon framework d’ingénierie de contenu en cinq étapes
Mon cadre de travail en ingénierie de contenu s’articule autour de cinq étapes ordonnées : vérifier rigoureusement les sources, verrouiller une seule intention, découper des sections calibrées, ouvrir chaque titre par une réponse directe et intégrer une réelle expérience de terrain.
Je déroule toujours ces étapes dans cet ordre exact. Sauter la phase de recherche pour passer directement à la mise en page aboutit inévitablement à des textes polis qui semblent assurés, mais qui s’avèrent creux ou factuellement faux.
Une recherche sans hallucinations (curation de sources et RAG manuel)
Avant de rédiger, j’ancre la page dans des sources vérifiées, des données réelles du produit et des lacunes délaissées par les concurrents : c’est le principe du RAG (génération augmentée par récupération), mais appliqué manuellement par un rédacteur.
J’analyse les premiers résultats sur la requête principale, je liste les questions qu’ils laissent sans réponse et je refuse d’intégrer toute statistique que je ne peux pas sourcer directement. Si un brief se résume à un mot-clé et à un volume de mots, je le renvoie aussitôt. Générer du contenu sans cadre strict remplit le texte de bavardage sémantique : de longues introductions, des adjectifs ronflants et aucune donnée concrète que le lecteur puisse vérifier.
Pour appuyer des fonctionnalités spécifiques, j’utilise des données de notre produit ou des captures d’écran. Pour les tendances du secteur, je place un lien vers la source d’origine. C’est ainsi que l’on préserve de vrais signaux d’expérience et d’E-E-A-T quand la moitié des résultats de recherche se compose de textes recyclés par des machines.
Une seule URL, une seule intention et des niveaux de titres stricts
Chaque page doit traiter une intention principale unique dans le titre et dans le H1. Les H2 portent les questions secondaires dérivées, et les H3 subdivisent les détails ou les listes sous ces H2.
Je ne regroupe jamais deux besoins d’utilisateurs distincts sur une même URL pour économiser des publications. Expliquer la définition d’un concept et comparer les meilleurs outils sur ce sujet relèvent de deux intentions différentes. Les mélanger affaiblit l’amorce de la page et fournit au modèle deux cibles d’extraction concurrentes. L’arborescence des titres sert de guide : H1 vers H2 puis vers H3, sans sauter de niveau et sans intercaler de labels vagues comme « Aperçu » ou « FAQ » qui ne posent aucune question précise.
Des sections adaptées à l’extraction (110 à 320 mots)
Chaque bloc sous une H2 ou une H3 doit idéalement compter entre 110 et 320 mots (soit environ 150 à 400 tokens) pour qu’un modèle de langage puisse l’extraire proprement sans devoir embarquer la moitié de l’article.
C’est le principe même du chunking de contenu. Au sein du paragraphe, j’évite d’utiliser des formules comme « comme mentionné ci-dessus », « ce point » ou « ce qui précède » comme unique élément de liaison : ces tournures perdent tout leur sens dès que l’extrait est cité de manière isolée. Si une section nécessite un rappel du contexte, je répète brièvement le nom du concept dans une proposition courte avant d’avancer.
Dès qu’un passage dépasse 320 mots sous un même sous-titre, je le découpe. Allonger un texte pour le plaisir de faire du volume n’améliore en rien la visibilité dans les moteurs d’IA ; poser des limites thématiques claires, en revanche, fait toute la différence.
Des réponses directes dès la première phrase et des triplets sémantiques
Les deux premières phrases sous chaque H2 et H3 répondent directement à la question posée dans le titre avant d’entrer dans les détails. Les formulations clés adoptent une structure claire : sujet, verbe et complément.
C’est cette amorce directe que privilégient les extraits optimisés de Google et les résumés génératifs d’IA. Une phrase telle que « l’ingénierie de contenu structure chaque page pour une intention unique et avec des blocs extractibles » surpasse n’importe quelle mise en bouche générale sur l’évolution du marché. De plus, ces triplets facilitent le travail d’identification des entités : affirmer que TrueRanker mesure les citations et les mentions dans ChatGPT et Gemini est bien plus simple à interpréter pour un modèle qu’un brouillard d’adjectifs qualificatifs.
J’écris toujours pour des personnes qui lisent sur leur smartphone : des paragraphes de trois à quatre lignes, des mises en gras stratégiques pour faciliter le survol et aucune introduction convenue sur le monde trépidant d’aujourd’hui.
Des signaux d’expérience et d’E-E-A-T impossibles à feindre avec l’IA
L’expérience de terrain se manifeste à travers des situations de travail vécues, des données chiffrées et des détails authentiques du produit, et non en affirmant haut et fort que l’on est un expert.
Les qualificatifs excessifs (« incroyable », « fondamental », « révolutionnaire ») et les amorces d’école nuisent à la confiance du lecteur. Je préfère montrer une requête précise, le titre qui n’obtenait aucune citation et la reformulation exacte qui a permis à l’IA de reprendre le passage. Le balisage Schema et le JSON-LD aident les robots à identifier les auteurs, les organisations et les articles ; ils ne remplaceront jamais un paragraphe que seule votre équipe pouvait écrire.
Les consignes de Google relatives aux contenus utiles rappellent exactement cela : le lecteur repart-il avec suffisamment d’éléments pour accomplir sa tâche ? C’est le test auquel je soumets chaque bloc avant de valider la publication.
Tableaux, listes et FAQ pour faciliter l’extraction
Les tableaux comparatifs, les listes à puces et les FAQ thématiques apportent des points de repère évidents aux lecteurs comme aux systèmes d’extraction automatique. Les pavés de prose continue créent l’effet inverse.
C’est pourquoi j’intègre systématiquement ces éléments structurés :
- Des tableaux HTML sémantiques pour les comparaisons directes (marketing face à ingénierie, SEO face à GEO, ou analyse de critères).
- Des listes à puces pour détailler des étapes, des composants ou des causes d’échec, avec une seule idée forte par puce.
- Des blocs de FAQ formulés sous la forme de questions orales naturelles avec des réponses autonomes.
- Des liens internes positionnés sur des termes associés à la cible, toujours après avoir résolu la question dans le paragraphe.
C’est de cette clarté que découle la conversion. Si le lecteur se demande quelle est la suite, je réponds à l’objection dans le texte, puis j’insère un lien vers l’outil ou le guide complémentaire. Je ne glisse jamais un appel à l’inscription au beau milieu d’une définition théorique qui n’a pas encore gagné l’adhésion de qui la lit.
Pourquoi une première page sur Google peut manquer l’AI Overview
C’est un constat récurrent : une page se classe en première page sur Google pour une requête pratique, mais l’AI Overview préfère citer un concurrent qui a répondu à la H2 dès la toute première phrase.
La section qui échoue débute souvent par trois paragraphes d’historique sous un titre comme « Suivre les rankings de mots-clés chaque jour ». Ce contenu peut être instructif en seconde lecture, mais il est inexploitable comme fragment autonome. La correction est simple et redoutablement efficace : résumer l’historique en une note brève, placer la méthode directement dans les deux premières lignes et clore le bloc autour de 220 mots avec une liste en trois points. Les positions dans Google ne bougent pratiquement pas ; en revanche, l’AI Overview trouve enfin un bloc net et structuré à citer. Le gain vient de l’extractibilité, pas d’un nouveau backlink.
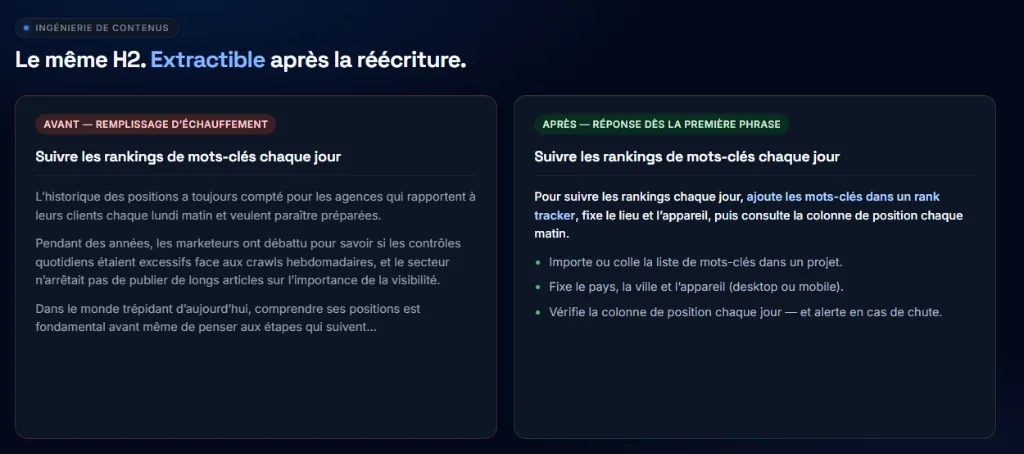
Le même mot-clé, la même page, mais de meilleurs extraits : voilà toute la valeur concrète de l’ingénierie de contenu illustrée en une seule image.
Comment mesurer les citations obtenues dans l’IA
Le suivi de positions classique vous indique si Google continue d’afficher votre URL dans ses résultats. Les mentions et les citations vous montrent si les assistants d’IA reprennent réellement vos contenus.
Après une refonte structurelle, j’observe trois signaux : la position traditionnelle sur la requête principale, la présence du nom de la marque mentionné dans la réponse et l’inclusion de l’URL en lien source. Ces deux dernières métriques ne doivent pas être confondues et se mesurent de façon distincte.
Si vous souhaitez effectuer un diagnostic rapide pour savoir si la structure de votre page est lisible par les moteurs génératifs, vous pouvez commencer par le vérificateur de visibilité IA gratuit. Pour mesurer votre visibilité dans l’IA sur la durée, vous devez toutefois vous appuyer sur un historique suivi sur les prompts stratégiques pour votre activité, et non sur une simple capture ponctuelle.
Un seul appel à l’action au milieu de l’article est largement suffisant : commencez par optimiser vos blocs de contenu, puis mesurez les résultats. Publier mille cinq cents mots de plus sans vérifier comment réagissent les modèles revient à commettre deux fois la même erreur.
Foire aux questions sur l’ingénierie de contenu
Qu’est-ce qu’un ingénieur de contenu et quel est son rôle ?
Un ingénieur de contenu conçoit l’architecture et la structure de l’information sur une page web pour que les lecteurs, les moteurs de recherche et les modèles génératifs puissent l’exploiter efficacement. Son rôle couvre les briefs, les plans de titres, les règles de découpage, la validation des sources et le suivi des citations dans l’IA, bien au-delà de la seule rédaction.
Certaines organisations séparent la gestion des contenus structurés de celle des flux d’IA. Dans des équipes SEO plus agiles, une même personne remplit souvent ces deux missions : elle définit les gabarits de page et écarte tout texte qui ne satisfait pas au critère de la réponse directe.
L’ingénierie de contenu est-elle équivalente au GEO ?
Non. L’ingénierie de contenu est une discipline globale qui consiste à structurer les pages pour répondre à une intention et maximiser l’extractibilité des données pour tout type de moteur. Le GEO (Generative Engine Optimization) est la branche spécialisée qui cible l’apparition et la citation dans les réponses formulées par les IA.
Vous pouvez pratiquer l’ingénierie de contenu uniquement pour le SEO classique. En revanche, faire du GEO sans de solides bases d’ingénierie se limite bien souvent à tester des astuces de prompts sur des pages que les moteurs ne prennent même pas la peine d’indexer.
Quelle est la longueur idéale pour chaque section ?
Il est conseillé de viser entre 110 et 320 mots par bloc sous une H2 ou une H3, afin que le passage conserve une taille optimale pour l’extraction par les modèles de langage ; s’il devient nettement plus long, scindez-le en deux sous-titres distincts.
C’est un repère méthodologique, pas une règle rigide dans le CMS. Une définition précise peut être plus courte. Un cas pratique accompagné d’un tableau peut atteindre le haut de cette fourchette. Si un sujet nécessite plus de cinq cents mots d’affilée, deux titres distincts seront généralement bien plus efficaces.
Faut-il encore travailler les mots-clés pour optimiser pour l’IA ?
Oui. Les mots-clés et l’intention de recherche déterminent toujours quels documents sont retenus lors de la phase initiale d’extraction avant qu’une IA ne génère sa réponse. Optimiser pour l’IA ne remplace pas la requête principale ; cela définit la manière dont vous organisez et rédigez votre contenu une fois cette intention identifiée.
Je place le mot-clé principal naturellement au début du titre et du H1. Les mots-clés secondaires ne sont intégrés que là où ils enrichissent logiquement l’argumentation d’une section, jamais pour atteindre un quota artificiel de répétition.
Vérifiez si les assistants d’IA peuvent extraire votre page
Lancez un test gratuit de visibilité IA et suivez vos mentions et citations dès que la structure de vos contenus est en place.
Écrit par
Javier Quevedo
Cofondateur & CEO, SEO Lead
Javier a cofondé TrueRanker et dirige le frontend, le site public et le dernier kilomètre entre un ranking en base et l’écran qu’un SEO utilise vraiment. Depuis des années, il transforme GEO, SEO local, on-page et visibilité IA en produit — et en guides sur ce blog — pour que les agences mesurent les citations ChatGPT comme elles mesurent déjà Google. Il travaille aussi le backend : une interface propre sur des données périmées reste un mensonge.